2016年5月18日水曜日

「これ以上は説明も回答もしない。」という嘘説明のFRPの基本原理コードなるもの

前回のエントリ記事、
本来のFRPを理解せず中傷を重ねる連中への再度宿題
にて、

以下再掲


http://anond.hatelabo.jp/20160516113354

関数型って時間はパラメータで与えて結果を得るんじゃないの

刻々と変化する「現在時間」を抽象化したインデックス

を変数で持ってたら、命令型じゃないの

だとか、

http://anond.hatelabo.jp/20160517022608

それをユーザから見て命令型変数への破壊的代入ではなく
参照透明な関数型インターフェースで実現するのが
いわゆるモナドや(誰かの独自解釈ではない本来の)FRP。

http://anond.hatelabo.jp/20160517023637

ライブラリユーザは現在時刻から状態への写像fを
参照透明な関数なりストリームなりで記述して、
それを処理系が実際のシステム時刻t=0,1,2,…に適用して
状態f(0),f(1),f(2),…を得る、という本来のFRPの基本原理

とか、君独自の勘違いFRPの解釈「本来のFRPの基本原理」で、書けるもんなら、
そのインデックスで、
システム時刻t=0,1,2,…に適用して状態f(0),f(1),f(2),…を得るという本来のFRPの基本原理で、
現在の状態を表せるとするFRP方式で、「お絵かきアプリ」をささっと実装してみせてください。

Date.now()であれ、
__a.tであれ、
「現在時間」というのは、本来的に「それ以外のシンボル」では表現できないので、
どういう魔法を使うのかたいへん興味があります。

以上、「本来のFRP 」を理解しておらず、出来もしない絵空事、机上の空論をあいも変わらず垂れ流してる例の自称関数型コミュニティへの宿題でした。


再掲終わり

と、「宿題」を出したところ、早速反応があったようです。

http://anond.hatelabo.jp/20160517162141

nonstarter氏をはじめもう1年ぐらい前から何度も示されてるんですが(以下無限ループ)

はい、嘘ですね。そんな彼ら独自の主張の路線のFRPコードなどどこにも示されていません。

連中の書き込み、
http://anond.hatelabo.jp/20160518122300
によると、
具体例は以下らしいです(笑)

http://qiita.com/nonstarter/items/2763f5d85f2b8df3b18b
main = playBanana disp colour freq gen
https://hackage.haskell.org/package/gloss-banana-0.1.0.4/docs/src/Graphics-Gloss-Interface-FRP-ReactiveBanana.html
playIO display colour frequency ()
(\ _ → readIORef pictureref)
(\ ev _ → () < tick time)
https://hackage.haskell.org/package/gloss-1.10.1.1/docs/src/Graphics-Gloss-Interface-IO-Game.html
playIO display backColor simResolution
worldStart worldToPicture worldHandleEvent worldAdvance
= playWithBackendIO defaultBackendState
display backColor simResolution
worldStart worldToPicture worldHandleEvent worldAdvance
False
https://hackage.haskell.org/package/gloss-1.10.1.1/docs/src/Graphics-Gloss-Internals-Interface-Game.html
, Callback.Idle (callback_simulate_idle
stateSR animateSR (readIORef viewSR)
worldSR (\_ -> worldAdvance)
singleStepTime)
これ以上は説明も回答もしない。

いやあのね、「これ以上は説明も回答もしない」って、そもそもこちらの「宿題」の説明にも回答にもなっておらないわけで、それ以上無理というのなら、まあ「想定の範囲内」で、案の定、適当ないつもの机上の空論だった、ということが、万人に追認される、証明されて、はいここまで終わり、ということで、
これ以上デマを流さない、という諦めの宣言とも取れるので、それは大変歓迎されることです。

一応、連中のハッタリ、嘘を精査して確認、証明していきましょう。

まず、冒頭の、

http://qiita.com/nonstarter/items/2763f5d85f2b8df3b18b
main = playBanana disp colour freq gen

これですが、
この書き込みが意図するとこであろう、リンク先
『関数型プログラミングに目覚めた!』のレビュー(Day-1)
の@nonstarter という捨てアカウントによる記事の該当部分は以下です。

ちなみに、大した意味はありませんが、敢えてFRPライブラリ(Reactive-Banana)を使うとこうなります:

ReactiveBananaDrawingCanvas.hs
import Data.Monoid (mconcat)
import Reactive.Banana (accumB)
import Graphics.Gloss.Interface.Pure.Game
import Graphics.Gloss.Interface.FRP.ReactiveBanana (playBanana)

main = playBanana disp colour freq gen
 where
  disp = (InWindow "Drawing Canvas" (400, 400) (40, 40))
  colour = white
  freq = 100
  gen deltaTime = return . fmap draw . accumB (False,[],[]) . fmap eTrans
  draw (_, path, paths) = mconcat $ map line $ path:paths
  eTrans (EventKey (MouseButton LeftButton) Down _ _ ) (_, path, paths) = (True, path, paths)
  eTrans (EventKey (MouseButton LeftButton) Up _ _ ) (_, path, paths) = (False, [], path:paths)
  eTrans (EventMotion pos) (True, path, paths) = (True, pos:path, paths)
  eTrans _ world = world

FRPライブラリを使ってもコードが先のものと殆ど変わらないことに注意してください。要するにこれらのコードの本質は状態遷移を純粋な関数(ここではeTrans)で表現するところにあり、イベントストリームやシグナル・ビヘイビアといったFRP特有の要素を用いるか否かにはないということが示されています。


まず、何度も書いてますが、なんでOCamlで書けないんだ?ってことがあります。
そもそもこちらの投げかけが、ごちゃごちゃ文句言うなら「Ocamlで机上の空論じゃないこと示せ」とかいうのに、いちいちHaskellのライブラリ頼みだっていうのが、語るに落ちる状態を明確に表しています。

さて、コードについてですが、

gen deltaTime = return . fmap draw . accumB (False,[],[]) . fmap eTrans

という行で、deltaTime デルタタイム、つまりここでなんか、タイマーのインターバルとってるっぽいですが、結局、

EventKey (MouseButton LeftButton) Down

とか、やってることは、そのまマウスイベントを流してるだけで、いったいどこに、

http://anond.hatelabo.jp/20160517023637

ライブラリユーザは現在時刻から状態への写像fを
参照透明な関数なりストリームなりで記述して、
それを処理系が実際のシステム時刻t=0,1,2,…に適用して
状態f(0),f(1),f(2),…を得る、という本来のFRPの基本原理

その「システム時刻t=0,1,2…」というインデックスから、
状態f(0),f(1),f(2),…を得るとかいう、彼らの言う「FRPの基本原理」みたいなもんがあるんですかね?(笑

残りは全部、使ってるライブラリのソースコードからfrequencyやリフレッシュレートやら、timerの解像度っぽいことをアピールしてるみたいですが、

タイマーの解像度設定しながらマウスイベントを同時にとってなんかやることと、

実際のシステム時刻t=0,1,2,…に適用して
状態f(0),f(1),f(2),…を得る、という本来のFRPの基本原理

ってまったく違うでしょ?
誤魔化すなと。

@nonstarterの書いたコードのどこに、「実際のシステム時刻t=0,1,2,…」をとった形跡があるのか?
その実際のシステム時刻tのストリームのFRPの値はどこ?
そしてどこに、状態f(t)とし取得している形跡があるのか?ってことです。

そんなもんはどこにも存在しない。
やってるのは、ただマウスイベントからFRP変数に流してるだけ。

まあ無理筋でいつもの、デタラメ、誤魔化しをやって、嘘でもなんでも、その場さえつくろえばいい、という考え方の連中なんで、真面目に受け取る学習者が被害を受ける毎度の害悪行為です。
わかってやってて、こうやって追求されると返しようがないこともわかってるので、
「これ以上は説明も回答もしない。」と予め逃げる予告をしている。

いやいや、あのね、こんなもんは嘘をつくだけ害悪で、こっちがこうやって逐一労力かけて指摘しないと、
思わせぶりのハッタリ行為になんか正しい意味がある、ああそうなんだ・・・
と信じてしまう人がでることをわかってわざとやってるんだろ?
いい加減にしろよと。

2016年5月17日火曜日

本来のFRPを理解せず中傷を重ねる連中への再度宿題

TimeEngine お絵かきアプリ(関数型リアクティブプログラミング/FRPのトイプログラム)について、

はてラボはてな匿名ダイアリーで、またいろいろ思い込みの激しい勘違いした批判が行われているので引用しながら、ひとつひとつ反論していきます。

ちなみに、今回も東北大の住井 英二郎@esumii、
自分が読み解けないFRPライブラリの実装について「スパゲッティ・コード」と書きなぐるだけの
らくだの卯之助@camloebaも居るようです。オモテで名前出してやったら?卑怯者が、というところです。


http://anond.hatelabo.jp/20160517094425

kenokabe氏のコードでもマウスが動くたびに同じ__drawFrom.tへの破壊的代入が行われるんですがそれは

..

http://anond.hatelabo.jp/20160517022608

それをユーザから見て命令型変数への破壊的代入ではなく
参照透明な関数型インターフェースで実現するのが
いわゆるモナドや(誰かの独自解釈ではない本来の)FRP。
http://elm-lang.org/examples/time

view : Model -&gt; Html Msg
view model =
  let
    angle =
      turns (Time.inMinutes model)

    handX =
      toString (50 + 40 * cos angle)

    handY =
      toString (50 + 40 * sin angle)
  in
    svg [ viewBox "0 0 100 100", width "300px" ]
      [ circle [ cx "50", cy "50", r "45", fill "#0B79CE" ] []
      , line [ x1 "50", y1 "50", x2 handX, y2 handY, stroke "#023963" ] []
      ]

HaskellのライブラリもElmのような言語も、サンプルもJavaScript実装も
ググればWikipediaで出てくるレベル。
https://en.wikipedia.org/wiki/Functional_reactive_programming#Implementations


まず、これなんですが、

いわゆるモナドや(誰かの独自解釈ではない本来の)FRP。

「(誰かの独自解釈)」というのは、おそらくこの投稿をした自分自身のことを自嘲的に言ってるのだと判断するしかないですが、
(誰かの独自解釈ではない本来の)FRP、というのは、ここで最前から書いておるように、再掲すると、


念の為ですが、TimeEngineのプロジェクトgithub.io ページ
http://timeengine.github.io/
にも書いていますが、1997年の論文で、http://dl.acm.org/citation.cfm?id=258973

Fran (Functional Reactive Animation) is a collection of data types and functions for composing richly interactive, multimedia animations. The key ideas in Fran are its notions of behaviors and events. Behaviors are time-varying, reactive values, while events are sets of arbitrarily complex conditions,

Fran (Functional Reactive Animation) として、初めてFRPを明示的にプログラミングパラダイムとして導入したことで知られているConal Elliottは、 
http://stackoverflow.com/questions/1028250/what-is-functional-reactive-programming
において、こう宣言しています。

I do resonate with Laurence G’s simple description that FRP is about - “datatypes that represent a value ‘over time’ ” -. Conventional imperative programming captures these dynamic values only indirectly, through state and mutations. The complete history (past, present, future) has no first class representation. Moreover, only discretely evolving values can be (indirectly) captured, since the imperative paradigm is temporally discrete. In contrast, FRP captures these evolving values directly and has no difficulty with continuously evolving values.
Dynamic/evolving values (i.e., values “over time”) are first class values in themselves. You can define them and combine them, pass them into & out of functions. I called these things “behaviors”.

面倒なんで全部訳しませんが、ポイントは、

  • FRP is about - “datatypes that represent a value ‘over time’ “
  • Dynamic/evolving values (i.e., values “over time”) are first class values in themselves.

FRPは「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
動的に時間発展する値(つまり時間軸上の値)はファーストクラスである、
ということです。


これで間違いありません。
私の以前から解釈しているFRPの特性とは、Conal Elliottが1997年に実装して発表し、
その後も各所で解説していて、
http://stackoverflow.com/questions/1028250/what-is-functional-reactive-programming
においても広くその見解の妥当性が認められているFRPの特性、概念と一致しています。

TimeEngineは、この
FRPは「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
動的に時間発展する値(つまり時間軸上の値)はファーストクラスである、
ということを簡潔に実装したFRPライブラリです。

ちなみに、

HaskellのライブラリもElmのような言語も、サンプルもJavaScript実装も
ググればWikipediaで出てくるレベル。
https://en.wikipedia.org/wiki/Functional_reactive_programming#Implementations

という「レベル」なるものについてですが、この多くは、
FRPは「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
動的に時間発展する値(つまり時間軸上の値)はファーストクラスである、
という「本来のFRPのパラダイム」が中心でなかったり、本末転倒なものが多く紛れ込んでおり、
「ググればWikipediaで出てくるレベル」というのが惨憺たる状況である多くの例のひとつであるといえます。

たとえば、この人物がいう(おそらく匿名で繰り返し言ってる)「Elmのような言語」ですが、
海外の掲示板では以前から

Neither Rx nor Elm are FRP. If you want FRP, look at Conal Elliott’s work.

「RxもElmもFRPではない。FRPがほしけりゃ、Conal Elliottの仕事を見ろ」
などと「本来のFRP」とのパラダイムのズレが指摘されていました。
パラダイムっていうものは、かようにWikipediaのリストごときで十把一絡げに簡単に論じれるようなものではなく、
関数型、オブジェクト指向しかり、たいがい論争に発展するようなものであり、
いろいろ意見を言うのは結構だが、そんなググってWikipediaのリストで「レベル」がどうのこうの断じるのは、この人物のレベルの底が知れるというものです。まあ、例の東北大の住井にしろ、あいかわらずいつもの匿名による発信なんで、文責も負わない、恥もかき捨てで結構なことですよね(笑

次に、

命令型変数への破壊的代入

とかいう、まあ、上記で示した本来のFRPの「意味」ってのを理解してないので、こういうことを平気で言えるんでしょうが、

TimeEngineによる、たとえば、

const __a = __();

として、定義されたものは、上記のとおり、
「動的に時間発展する値(つまり時間軸上の値)はファーストクラス」
であり、その集合のうちの現在時間を指し示すものが、
__a.tです。

JavaScriptのDateで考えれば、

Date.now()
であり、「現在時間」というのは、本来的に「それ以外のシンボル」では表現できません。

__a というのは、
「動的に時間発展する値(つまり時間軸上の値)はファーストクラス」
という集合値であり、名実ともに、Constantでイミュータブルな値です。
そのうちの「現在時間」というのは、「読み出した時点」で一意に自明的に決定されるわけで、
__a.tというのは、

命令型変数

でもなければ、「破壊的代入」するものでもありません。

たとえば、それこそ東北大の住井らしき人物がまた匿名で、

http://anond.hatelabo.jp/20160516112619

kenokabeさんの心の中ではそうなのかもしれませんが、ライブラリのユーザから客観的に見れば(分析哲学ではなく関数型言語の意味で)参照不透明なので、関数型プログラミングのメリットは享受できない、命令型の破壊的代入と等価ですね。

であるとか、

http://anond.hatelabo.jp/20160516192742

実際、timeengine.js を読み込んだ状態で、以下のようになります。

> const __x = __();
undefined
> __x.t = 1;
1
> __x.t = __x.t + 1;
2
> __x.t;
2

これは岡部健氏が著書で「論理破綻」と批判していた、命令型言語の破壊的代入そのものです。
なお私を他の誰かと決めつけるのは、その方たちにご迷惑ですのでおやめください。
……と言っても聞き入れていただけるとは思えないので、私ももうこれ以上の書き込みはやめます。
できるだけ丁寧に技術的な誤りだけを指摘したつもりですが、やはり誹謗中傷しか返ってこないようで残念です。

http://anond.hatelabo.jp/20160517094425

などと書いているのですが、いま説明しているように、

Date.now = Date.now + 1

というステートメントが、概念的な意味を成さないように、
=の両辺が等しいという、関数型プログラミングのパラダイムにおいては、

__x.t = __x.t + 1;

というFRPライブラリの使用は概念的な意味を成しません。
なんでこういうことをするのか?というと、なんか悪意があるか、
それとも、FRPが「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
ということを全く理解していないから、こういう文句のつけかた、それこそ誹謗中傷をして平気なのでしょう。

あえてこの住井らしき人物がわざとやらかした「破壊的代入」という命令型パラダイムにおいて、考えてみると、この人物の意図によると、
「右辺の現在値」を「左辺の現在値」に代入するという命令型の時系列的意図しかありえないでしょうから、

右辺の現在値に1を加えて、改めて、左辺の現在地とする

ということです、つまり、左辺、右辺の現在時間が異なる、FRPライブラリにおいては、
.tによって表現される時刻による「時間軸上の値」は異なって当然であるということになります。

よって、

__x.t = __x.t + 1;

というのは、
右辺を評価した現在時間における
__x上のある値に1を加えたものを
次の瞬間以降の
__x上の値として更新する、という意味合いになります。

もちろん、これは、=の左右で値が異なるという命令型ステップの解釈であり、
そういう命令形パラダイムを大前提とした記法においては、TimeEngineの振る舞いはこう解釈される、
ということにすぎませんし、そのような記法を禁じるようなSanityCheckを実装しているわけではありません、
ご自由にどうぞ、といったところでしょうか。

また、

次に、

http://anond.hatelabo.jp/20160516113354

関数型って時間はパラメータで与えて結果を得るんじゃないの

刻々と変化する「現在時間」を抽象化したインデックス

を変数で持ってたら、命令型じゃないの

などという意味不明な書き込みもあります。

「お絵かきアプリ」みたいな
「現在時間におけるマウス座標」を保持するときには、

Date.now()
であり、「現在時間」というのは、本来的に「それ以外のシンボル」では表現できません。

と書いたとおり、
「>>刻々と変化する「現在時間」を抽象化したインデックス」
つまり、nowやらt以外では、原理的に不可能です。

さーて、この勘違いした連中がいったいどういう魔法を使って
「現在時間における状態」について
「関数型って時間はパラメータで与えて結果を得る」のか是非見てみたいものです。
100%無理でしょうが(苦笑

「関数型って時間はパラメータで与えて結果を得る」とか書いてるってことは、
もはや、限定された「状態渡し」ではない、「この連中なりの独自解釈におけるFFP」のお話をしているつもりなのでしょうから、
FRPをつかって、「関数型って時間はパラメータで与えて結果を得る」という設計で、
お絵かきアプリを実装してみせてください。これが当方からのこの連中への課題ということになります。

さて、この件について、「非常に悪質な誤魔化し」が現在進行中であることも当然抑えておかなければなりません。それがすなわち、冒頭に示したコードです。

それをユーザから見て命令型変数への破壊的代入ではなく
参照透明な関数型インターフェースで実現するのが
いわゆるモナドや(誰かの独自解釈ではない本来の)FRP。
http://elm-lang.org/examples/time

view : Model -&gt; Html Msg
view model =
  let
    angle =
      turns (Time.inMinutes model)

    handX =
      toString (50 + 40 * cos angle)

    handY =
      toString (50 + 40 * sin angle)
  in
    svg [ viewBox "0 0 100 100", width "300px" ]
      [ circle [ cx "50", cy "50", r "45", fill "#0B79CE" ] []
      , line [ x1 "50", y1 "50", x2 handX, y2 handY, stroke "#023963" ] []
      ]

これは、アナログ時計のコードなんですが、
アナログ時計のコードって、「現在時間」を表現していますが、
現在の状態について、「時間はパラメータで与えて結果を得る」コードでもなんでもありません。

この時間の離散値を得た上で、FRPに流し込むというのは、
TimeEngineで、前からさんざんやっていて、それはだから、物理の斜方投射のDemoでもっと高度な形でやっているわけです。

http://timeengine.github.io/
の
Demo #3ですね。

const t = __
      .intervalSeq(Immutable.Range(), 10)
      .__((count) => (count * 10 / 1000));
    const x = __([t]).__(([t]) => V0 * Math.cos(THETA) * t);
    const y = __([t]).__(([t]) => V0 * Math.sin(THETA) * t - 1 / 2 * G * Math.pow(t, 2));

というわけで、Immutable.jsの無限ストリームを10マイクロセカンド解像度で、時間軸にマップして
const t を得ています。

このなんか嬉しそうに貼り付けてきたアナログ時計っていうのは、ようするにそれの劣化版でしょ?
それでですね。こういう時刻の離散値ストリームを本来のFRP値として、このように、

const tとして表現することなんて普通にできるわけですが、
このtをもって「現在時間値」を表現することは「不可能」です。
だって、tが表すのは、「動的に時間発展する値(つまり時間軸上の値)」でしかないわけで、
「現在値」というのは、それ以外のシンボルでは表しようがない、
なにかカウントされたインデックスで表せるわけがないわけで、それを抽象化したものを.tとし、
t.tとするしか方法はありません。

TimeEngineは当然私が自分自身で実装したので仕掛けは熟知していますが、
この、

const t = __
      .intervalSeq(Immutable.Range(), 10)
      .__((count) => (count * 10 / 1000));

というのは、根本的には、SetIntervalもしくはSetTimeoutのラッパーで、
タイマーのイベントドリブンの周期をImmutable.jsの無限ストリームで表現しています。

angle =
      turns (Time.inMinutes model)

もこれは、根本的には、タイマーのイベントドリブンです。

タイマーのイベントドリブンでやってるのと、
マウスのイベントドリブンでやってるのは同じだし、

システム時刻t=0,1,2,…に適用して状態f(0),f(1),f(2),…を得る

なんて動作はこのアナログ時計のコードはやっていません。

実際に、私は「お絵かきアプリ」のトイコードを書くときに、
const t なんてものをインデックスとして取得することなどしていません。
それは単に、根源的にはタイマーイベントであり、
マウスのアプリは、マウスのイベントでアプリは挙動するからです。
アナログ時計のアプリが、タイマーのイベントを取るのは当たり前で、
それは、

システム時刻t=0,1,2,…に適用して状態f(0),f(1),f(2),…を得る

という「FRPの根本原理(笑)」だから、そうなってる、わけもありません。

現在の状態は、システム時刻のインデックスでやるのが、関数型で、FRP、とか、まあ大嘘で、
この連中が無知と勘違いでデマや嘘を垂れ流している様子にはいい加減辟易しています。

“

http://anond.hatelabo.jp/20160517023637

命令型プログラムをFRPとか言ってる人が決定的に理解していない点は、
ライブラリユーザは現在時刻から状態への写像fを
参照透明な関数なりストリームなりで記述して、
それを処理系が実際のシステム時刻t=0,1,2,…に適用して
状態f(0),f(1),f(2),…を得る、という本来のFRPの基本原理だと思う。
まさに実装は命令的だけど(誰かさんもそこは正しい)、
ライブラリユーザは参照透明な関数型の記述が可能。

うんだから、この人物が言う「本来のFRPの基本原理」というのは完全に間違っているし、
書き換えてあげると、
処理系の実際のシステム時刻t=0,1,2,…を
- FRP is about - “datatypes that represent a value ‘over time’ ”
- Dynamic/evolving values (i.e., values “over time”) are first class values in themselves.

FRPは「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
動的に時間発展する値(つまり時間軸上の値)はファーストクラスである、

という時間軸上にマップして、

const t = __
      .intervalSeq(Immutable.Range(), 10)
      .__((count) => (count * 10 / 1000));

別の状態に再度マップする、

   const x = __([t]).__(([t]) => V0 * Math.cos(THETA) * t);
    const y = __([t]).__(([t]) => V0 * Math.sin(THETA) * t - 1 / 2 * G * Math.pow(t, 2));

ことくらいは、こっちはとっくの昔にやってみせているわけ。いいかな?

そうじゃなくて、ここでの問題は、再三いいますが、

http://anond.hatelabo.jp/20160516113354

関数型って時間はパラメータで与えて結果を得るんじゃないの

刻々と変化する「現在時間」を抽象化したインデックス

を変数で持ってたら、命令型じゃないの

だとか、

http://anond.hatelabo.jp/20160517022608

それをユーザから見て命令型変数への破壊的代入ではなく
参照透明な関数型インターフェースで実現するのが
いわゆるモナドや(誰かの独自解釈ではない本来の)FRP。

http://anond.hatelabo.jp/20160517023637

ライブラリユーザは現在時刻から状態への写像fを
参照透明な関数なりストリームなりで記述して、
それを処理系が実際のシステム時刻t=0,1,2,…に適用して
状態f(0),f(1),f(2),…を得る、という本来のFRPの基本原理

とか、君独自の勘違いFRPの解釈「本来のFRPの基本原理」で、書けるもんなら、
そのインデックスで、
システム時刻t=0,1,2,…に適用して状態f(0),f(1),f(2),…を得るという本来のFRPの基本原理で、
現在の状態を表せるとするFRP方式で、「お絵かきアプリ」をささっと実装してみせてください。

Date.now()であれ、
__a.tであれ、
「現在時間」というのは、本来的に「それ以外のシンボル」では表現できないので、
どういう魔法を使うのかたいへん興味があります。

以上、「本来のFRP 」を理解しておらず、出来もしない絵空事、机上の空論をあいも変わらず垂れ流してる例の自称関数型コミュニティへの宿題でした。

2016年5月6日金曜日

TimeEngine お絵かきアプリ(関数型リアクティブプログラミング/FRPのトイプログラム)

TimeEngine
https://www.npmjs.com/package/timeengine
https://github.com/TimeEngine/timeengine
プロジェクトgithub.io ページ
http://timeengine.github.io/
の「素朴実在論」の画像リンクなどが切れていたので、メンテナンスついでに
お絵かきアプリのLIVE-DEMOを追加しました。

Demo #9

Simple Draw

のところに

DRAW HERE ↓

として実装したCanvasを埋め込んでいます。

念の為にソースコードを再掲:

    const canvas = document.getElementById('canvas1');
    const ctx = canvas.getContext('2d');
    const __mouseDown = __();
    const __drawFrom = __();
    const __drawTo = __()
      .__(
        (val) => {
          ctx.beginPath();
          ctx.moveTo(__drawFrom.t.x, __drawFrom.t.y);
          ctx.lineTo(val.x, val.y);
          ctx.closePath();
          ctx.stroke();
          __drawFrom.t = val;
          return val;
        }
    );
    canvas.onmousedown = (e) => {
      __mouseDown.t = 1;
      __drawFrom.t = {
        x: e.clientX,
        y: e.clientY
      };
    };
    canvas.onmouseup = (e) => {
      __mouseDown.t = 0;
    };
    canvas.onmousemove = (e) => {
      if (__mouseDown.t === 1) {
        __drawTo.t = {
          x: e.clientX,
          y: e.clientY
        };
      }
    };

なぜ今、「お絵かきアプリ」なのかというと、まあ以前から何かとあちらこちらであることないこと吹聴して当方を中傷誹謗してきた住井 英二郎@esumii、らくだの卯之助@camloebaなどが存在していて(こちらは文句言われてることに気がつくまでこの関数型プログラミング界隈のろくでもない連中のことなど知らんかった)、彼らがOCamlに傾倒しているのは勝手だし、結構なことだが、まあお世辞にも一般的に実用的なアプリの範疇で普及しているとは言い難いOCamlのようなプログラミング言語をもって、広く一般的なプログラマあるいはこれから実用的なアプリを書こうとしようと勉強している初学者に向けて、まるでその延長線上で実用的なアプリが書けるかのようなトーンでいろいろ言っていることに苦言を呈したことがありました。つまり、入門者が一生懸命やったって「出口」が見えにくい、ということです。

住井 英二郎@esumiiさんとか、らくだの卯之助@camloebaさんに聞きたいのだけど、そもそも貴方たちはOCamlでデスクトップアプリ書けるんですか?

個人的に、OCamlを振り回して、国内で関数型プログラミングで、なんかこういう、私の主張にたいしても上から目線で偉そうにごちゃごちゃ文句いってくる連中が、GUIアプリ書いてる事象を目撃したことがこれまで一度もない。
なんで?

そういうことです。

そうすると、まあ嘘くさい喧伝への批判、つまり実用的なスキームにおけるポテンシャルの限界という、彼らが初学者にはけして(正直に)語らない要素はの指摘は彼らにとっては触れられたくない、気に入らない要素であるわけで、
http://qiita.com/nonstarter/items/2763f5d85f2b8df3b18b
例の当方への批判記事に即座に
追記(2015/05/30):デスクトップアプリケーション??

という追記が@nonstarterなる捨てアカウントの人物よりなされました。(基本、著作について著者の実名をもって批判する際にこのように匿名の捨てアカウントで批判するのは、卑怯だと思いますし、住井 英二郎@esumii、らくだの卯之助@camloebaについても、
Qiitaの騒動から派生して、東北大学の住井 英二郎@esumii氏、らくだの卯之助@camloeba氏その他が、犯罪者集団に合流して2ちゃんねるでの誹謗中傷チームの「8賢者」「ウィザード組」とかアホなことをやってる件についてというように、極めて卑劣な手段をもって、当方に「対抗」しようとしているとか、もうこの関数型プログラミングにまつわる連中の姿勢、行動の一切合切が胡散臭く、単なる「関数型プログラミングコミュニティ」とかいうろくでもない縄張り意識を守りたいがためになんか攻撃してくる、程度のことでしょう。)

著者はブログで@camloebaさんや@esumiiさんにデスクトップアプリケーションをOCamlで作成するように求めているようです。著者が挙げている「クリックカウンター」や「お絵かき」の類を作成するのに特別なexpertiseは不要で、単に使用するGUIライブラリ・グラフィックスライブラリのドキュメントが読めれば充分なので、その趣旨は私にはまったく判然としません(当該の記事で著者がOCamlで「お絵かきロジック」を実装してみせよと要求する一方で自身ではJavaScriptによるそれを公表していない点も気になります)。もちろん、OCamlであれHaskellであれ破壊的代入の類の副作用を使用せずに書くのもなんら困難ではありません。
(追記:コメント欄にてyataketa9056さんに、既存のGUIライブラリを前提にスケールするコードを書こうとするとOCamlでは困難であろうという指摘を頂いています。利点はともかくHaskellと同じようにモナドを利用したライブラリを作成するなら純粋な関数型でのプログラミングも可能になる(けれどもOCamlプログラミングとしてはわざわざそのようなことをしても嬉しくはない)ということになります。とはいえ原理的に不可能でないのなら(そして不可能でないので)、純粋な関数プログラミングでGUIアプリケーションを作成するのにFRPがなんら必要でない、という趣旨には充分です。またこの主張自体はHaskellでのコードによっても充分に示されています。)

まず、「単に使用するGUIライブラリ・グラフィックスライブラリのドキュメントが読めれば充分なので、その趣旨は私にはまったく判然としません」ということですが、彼自身自覚したコメントで突っ込みがあるように、「OCaml の全ての GUI ライブラリは状態は副作用を使うことを前提にメインループが設計されている」わけで、そんなことは、巷のOCamlの関数型の本のくせに実用むけ章になった途端に破壊的代入しまくりで「なんじゃこれ、関数型じゃないし」と私が書いて、連中がなんか怒っちゃたくだりでもう終わってる話です。

追記の後半部分の(追記)は重要で、まさに語るに落ちるという感じで興味深いです。

原理的に不可能でないのなら(そして不可能でないので)、純粋な関数プログラミングでGUIアプリケーションを作成するのにFRPがなんら必要でない、という趣旨には充分です。

とか、こちらはそもそも実用的な観点から、そんなもんは無理筋だ、という論旨の展開をしておるのに、「原理的に不可能でないなら」「という趣旨には十分です。」と、また机上の空論ぶりを全開に吐露したり、「またこの主張自体はHaskellでのコードによっても充分に示されています。」とか、なんでOCamlの実用的な限界を論じているのにHaskellのコードによってでしか「充分に示されない」のか?とかツッコミどころが満載で、非常におもしろいです。

もう一度確認すると、私の基本的な観察としては、

個人的に、OCamlを振り回して、国内で関数型プログラミングで、なんかこういう、私の主張にたいしても上から目線で偉そうにごちゃごちゃ文句いってくる連中が、GUIアプリ書いてる事象を目撃したことがこれまで一度もない。
なんで?

というのがあるのですが、この第三者が指摘したとおり、既存のGUIライブラリを前提にスケールするコードを書こうとするとOCamlでは困難であろう、ことは状況をざっと見れば誰でもすぐにわかります。

そりゃチューリング完全なプログラミング言語であれば「原理的」に実現不可能なプログラミング課題というのは存在しないのですが、「原理的」とか机上の空論のおはなしではなくて、実際上の観点から言うと、OCamlというのは、そもそもそういう入出力が発生する時間遷移することが主題の実用的なデスクトップアプリケーションの実現にまったく熱心ではない言語環境である、程度の共通理解は得られるでしょう。

OCamlは関数型プログラミング言語を標榜している一方で、GUI関連になると明らかに非関数型でしか書けない解説で満ち溢れていて、複雑なGUI、入出力の段になると関数型で書くことが困難な自覚はあるっぽい。「既存のGUIライブラリを前提にスケールするコードを書こうとするとOCamlでは困難」。しかし何故か、FAQ.入出力は「純粋な関数型プログラミングでも、入力を引数、出力を戻り値とする関数を考えることにより、入出力も表現できます。」などと、ぶちあげるだけはぶちあげて、将来的にその言葉を信じてついていった学習者が壁にぶち当たることはけして解説されていない、という胡散臭い状況があるわけです。

こういった問題の象徴として出てきたのがこの「お絵かきロジック」あるいは「お絵かきアプリ」です。
関数型プログラミングの文脈からいくと、あくまで原理的でも机上の空論でもない関数型プログラミングとしての軸をとると、関数型リアクティブプログラミング(FRP)が必要になります。

今回私が自作のFRPライブラリのDEMOコードとして追加した、当記事の冒頭のお絵かきアプリのコードは極めて簡潔ですが、簡潔に書けるのはあくまでもFRPで設計してるからです。念の為ですが、すべての値は、constとなっています。

さて、@nonstarterなる捨てアカウントの人物の言い分によると、

いずれにせよ、状態機械の数学的構成では状態遷移が状態と入力から状態への関数として表現されるというだけのことではあり(状態渡し)、状態遷移が複雑になれば状態遷移を純粋な関数として表現する作業も複雑になり困難になるので(そしてそれはしばしば綺麗な関数合成では上手くいかないようなものになることが多いので)、結局のところ少なくとも現状のFRPも(イベントのシグナルから状態のシグナルを構成する際に状態遷移をそうした関数で表現する必要が出てくるので)本質的には銀の弾丸にはならないと言わなければなりません(関数プログラミングで書けるということの恩恵はもちろんあるとしても)。

だそうです。
まったくわけのわからない言い分ですね。

大事なポイントは、「(状態渡し)」で時間遷移していく、複雑なことが普通である実用的アプリケーションを書こうとすると、

  • 状態遷移が複雑になれば状態遷移を純粋な関数として表現する作業も複雑になり困難になる

  • そしてそれはしばしば綺麗な関数合成では上手くいかないようなものになることが多い

ということです。まあこの捨てアカウントの人物はその程度の理解と自覚はしっかりあるようですし、ここまでは言ってる意味はわかるし、普通に正しい(それ以降は全部間違っていますが)。

彼が言ってる正しい部分をまさに私は指摘している。それは根本的に、時間遷移の概念を関数型のパラダイムに抽象化したFRPを適用していないのが問題なのであって、あんたらはそんなことは一切触れずに、まるで、「(状態渡し)」で最終的になんでもできるかのように、初学者に向けても説明してるじゃないか、というか、実際、OCamlで実用的なデスクトップアプリを書いてるのみたことないけど、できるの?そんなに言うなら書いて見せてよ?、、、というところまでが、私の「問題提起」なのでした。

ここまでは当然この胡散臭い捨てアカウントも理解しているようですが、続いて、

結局のところ少なくとも現状のFRPも本質的には銀の弾丸にはならないと言わなければなりません

(多分何がなんでも自分の理解を超える要素は否定したいと大風呂敷を広げる)
一応とってつけた理由:

(イベントのシグナルから状態のシグナルを構成する際に状態遷移をそうした関数で表現する必要が出てくるので)

???????意味不明。
まあ、この人物がFRPが何たるか理解していないのは、ほぼ確実でしょう。
FRPの本質は「時間軸」のプログラミング言語上での抽象化であり、なんかわけわかりませんが、この一連の議論で、FRPという言葉さえでてくるも、「時間」とか言っているのが私ただひとりだけ、という非常にわけのわからない、もとい、ある意味、連中がどういう知見レベルをもって当方を批判、あるいは中傷しているのかが非常にわかりやすい状況です。

念の為ですが、TimeEngineのプロジェクトgithub.io ページ
http://timeengine.github.io/
にも書いていますが、1997年の論文で、http://dl.acm.org/citation.cfm?id=258973

Fran (Functional Reactive Animation) is a collection of data types and functions for composing richly interactive, multimedia animations. The key ideas in Fran are its notions of behaviors and events. Behaviors are time-varying, reactive values, while events are sets of arbitrarily complex conditions,

Fran (Functional Reactive Animation) として、初めてFRPを明示的にプログラミングパラダイムとして導入したことで知られているConal Elliottは、 
http://stackoverflow.com/questions/1028250/what-is-functional-reactive-programming
において、こう宣言しています。

I do resonate with Laurence G’s simple description that FRP is about - “datatypes that represent a value ‘over time’ ” -. Conventional imperative programming captures these dynamic values only indirectly, through state and mutations. The complete history (past, present, future) has no first class representation. Moreover, only discretely evolving values can be (indirectly) captured, since the imperative paradigm is temporally discrete. In contrast, FRP captures these evolving values directly and has no difficulty with continuously evolving values.
Dynamic/evolving values (i.e., values “over time”) are first class values in themselves. You can define them and combine them, pass them into & out of functions. I called these things “behaviors”.

面倒なんで全部訳しませんが、ポイントは、

  • FRP is about - “datatypes that represent a value ‘over time’ “
  • Dynamic/evolving values (i.e., values “over time”) are first class values in themselves.

FRPは「時間軸上の値を表現したデータタイプ」についてのパラダイムである、
動的に時間発展する値(つまり時間軸上の値)はファーストクラスである、
ということです。

したがって、
「いずれにせよ、状態機械の数学的構成では状態遷移が状態と入力から状態への関数として表現されるというだけのこと」とか、そういうおはなしとは全く別の話題ですし、
FRPでは「(イベントのシグナルから状態のシグナルを構成する際に状態遷移をそうした関数で表現する必要が出てくる)」なる言及は、FRPのパラダイムを論じる上で意味を成しません。

(関数プログラミングで書けるということの恩恵はもちろんあるとしても)。

これもどういう意味なのか全く意味がわかりません。
とにかく、力づくで理屈を捻じ曲げても、とにかくFRPという彼にとっては新しい未知の概念の導入なんて無意味だ、ということを力説したいという熱意だけは伝わってきます。

ちなみに、大した意味はありませんが、敢えてFRPライブラリ(Reactive-Banana)を使うとこうなります:

大した意味がないどころか、FRPライブラリを導入するということは、時間軸上の展開している値をファーストクラスにして、時間発展する系を関数型プログラミングの枠組みで統一的に取り扱えるようにする、という甚大なパラダイムの変化であり、大きな意味があります。
 

FRPライブラリを使ってもコードが先のものと殆ど変わらないことに注意してください。要するにこれらのコードの本質は状態遷移を純粋な関数(ここではeTrans)で表現するところにあり、イベントストリームやシグナル・ビヘイビアといったFRP特有の要素を用いるか否かにはないということが示されています。

そりゃさ、この程度ならば「殆ど変わらない」のだが、とりもなおさず君自身が言ってたとおり、

  • 状態遷移が複雑になれば状態遷移を純粋な関数として表現する作業も複雑になり困難になる

  • そしてそれはしばしば綺麗な関数合成では上手くいかないようなものになることが多い

という状況が顕在化するばするほど、「殆ど変わらない」どころか、本質的な違いが顕在化する。

まず批判ありきで私個人を中傷するにとどまらず、何も知らんくせに、FRPの意味もわかってないくせに、批判ありきのFRP不要論の大風呂敷を広げる、適当な屁理屈をとってつけて読者を惑わせて恥ずかしくないの?と思う。自称大学の教職にある捨てアカウントらしいが、知的誠実さが少しでも残っているのならば、ただちに修正することをおすすめする。言っても無駄でしょうが。どうせ捨てアカウントだし、こちらを中傷し放題で、自分は間違ったデマを垂れ流しても、恥はかき捨てで大変結構ですね。割を食うのは学習者です。まあやっぱり恥を知ってほしいです。

FRPは、時間発展する系の時間軸上の値をファーストクラスにして扱うというパラダイムであり、TimeEngineは、時間軸上の値をJavaScriptのファーストクラスとして提供する、FRPライブラリとして開発しました。

お絵かきアプリのLIVE-DEMOですが、明確な設計思想、つまり
時間軸上の値をJavaScriptのファーストクラスとして提供する
という設計思想をもって自分で開発したFRPライブラリを使って、

  1. mouseイベントからFRPの値に表現
  2. FRPの値の構成をcanvasと接続する

というだけですから、簡潔かつ、設計もコーディングも単純、つまり簡単です。
実質コーディング時間は10分程度だったんじゃないでしょうか?
実際に、プロジェクトgithub.io ページ
http://timeengine.github.io/
に列挙している他の、たとえばカウントアプリのほうがよほど複雑なわけで、これは一番簡単な部類に入ります。

ぶっちゃけ、TImeEngineの各DEMOのプレゼンテーションだけでも、お絵かきアプリは一番カンタンな部類だということはわかりそうなものですが、
こういう胡散臭い連中は、「言い聞かせてもわからない」「自分に都合の良い、相手に都合が悪くなりそうな設定を信じたいように信じる」病人なので、

ところで岡部はいつになったら彼の言う「お絵かきロジック」を破壊的代入を用いない関数型のJavaScriptで書いてみせるんだろうか。
そんなトイプログラムのコードも示せないとなると岡部のCS理解とコーディング能力は推して知るべしということになるわけだが。

だとか、

目が潰れそうなスパゲティコードだが、これでは「お絵かきロジック」のようなトイコードすら関数型で書けはしないということは岡部健自身が一番よくわかっているだろう。お前さんがDate.now()で岡部がかいた恥をほじくり返して晒すのは死者に鞭打つようなものだ。もし反論したければ、お前さんがこのオモシロ timeengine で「お絵かきロジック」を関数型で書いてみせてくれればいいのだよ。簡単だろう(笑う)。まあ、できやしないのはわかりきっているのだが(とはいえそれができないのは岡部のせいなので気に病む必要はない)。

だとか、

こうして絶対にコードを書かずにいつまでも逃げまわるのであったwww

だとか、言ってるようで、頭痛が痛くなってきます。
まあ、TimeEngine自体を開発するのは、かなり大変でしたが、冒頭のコードみたいなお絵かきアプリを書くのは、かなり簡単です。

これが簡単な作業だとわからない連中に向かって、簡単なコードをついでにUPしなかったのは、「ほんとうにしょうもない」と心底思っていたからです。

いやこの10分でかけるコードを書くのに、1年くらいかかった!とか、またしょうもない中傷、妄想を続けるのは自由です。
実際「2ヶ月たってもお絵かきアプリを書けない」「3ヶ月たってもお絵かきアプリを書けない」とか、延々と中傷していましたね?中傷というか、ナイーブに本気でそう思ってったぽいのは、知見レベルが低いのか、思いこみの強い病的な性向によるものなのか、いずれにせよかなり気持ち悪いです。

実際、簡単なコードだ、とUPして見せて理解できるのかさえもよくわかりませんが、少なくともこんなもんが難しい課題だと少しでも思ってるのは本当にJavaScriptでFRPを書くのが困難だ、と本気で思ってればそういう気持ちになりえるのかな?とは想像可能です。が、正直頭のおかしい連中のことはよくわかりません。
今後もこれまでと変わらず、自分が信じたいことだけ信じて、初学者を惑わすデマを拡散していってください。

住井 英二郎@esumiiさんとか、らくだの卯之助@camloebaさんに聞きたいのだけど、そもそも貴方たちはOCamlでデスクトップアプリ書けるんですか?

OCamlで書かれた「お絵かきデスクトップアプリ」に関しては、らくだの卯之助@camloebaあたりがUPした、ガッタガタのそれこそトイアプリを見ましたが、私がまともなもんを見る日は来るのでしょうか?

らくだの卯之助‏@camloebaさん、あなたが自身の関数型プログラミングのスキルが「机上の空論」でないことを示せ。

という投げかけには、示されていない、無回答であるということになります。非常にしょうもないことですが、改めて連中のノリを観察すると、本気で、こちらが「お絵かきアプリ」を書かない、というか、あほらしいので書くまでもなく放置していることを心の拠り所にしていたっぽいので、今回改めて、明示的にもう一度、ボールを投げ返しておきます。

そういえば、「関数型言語」に関するFAQ形式の一般的説明
にも、

それだと入出力や状態(state)すら表せないのでは?

いいえ、純粋な関数型プログラミングでも、入力を引数、出力を戻り値とする関数を考えることにより、入出力も表現できます。

と、すでに引用した@nonstarterなる捨てアカウントの人物の言い分

いずれにせよ、状態機械の数学的構成では状態遷移が状態と入力から状態への関数として表現されるというだけのことではあり(状態渡し)’

と全く同じことが書かれており、住井@esumii が語る、関数型プログラミングの、時間遷移する複雑なアプリの実用性は、すべて(状態渡し)一点で処理しようとしているように見えます。少なくとも私は、
@nonstarterはもとより、らくだの卯之助‏@camloeba、住井@esumii その他とりまきの自称関数型コミュニティの連中が「動的に時間発展する値を、時間軸上の静的な値として俯瞰し、ファーストクラスとして扱う」というコンテクストにおける正しいFRPの文脈で話しているのは一度たりとも見たことがありません。

まあデタラメな知識でFRPがなんたるか理解せず、意味不明な言説をもってFRPの導入の妥当性を全力で否定した上で、(状態渡し)一点ばりの問題点

  • 状態遷移が複雑になれば状態遷移を純粋な関数として表現する作業も複雑になり困難になる

  • そしてそれはしばしば綺麗な関数合成では上手くいかないようなものになることが多い

と宣言しているということは、連中のOCamlでのコーディングの実用性は、上記が上限だということになります。そういうことですよね?(笑)

2016年3月21日月曜日

ベイズ推定、条件付き確率について多世界解釈と参考資料の追加など

前回、ベイズ導入とベイズ統計的機械学習参考書の紹介など
で、筆者が考えうる限りもっとも簡潔なベイズ推定の概念導入を試みましたが、それなりの反応をいただきました。

やはり疑問、というか納得しにくい、納得した上で先に進みにくいのがベイズの定理であるようで、それが自然だとも思います。

「なんかひっかかる」「納得しにくい」という概念が現れたときは、そこは素通りすべきではないと思います。ほとんどの場合そこには大きな発想、パラダイムの転換(コペルニクス的転換)またブレイクスルーが存在していて、そこを突き詰めて考察することはとても有意義で楽しいことです。また逆にそういうパラダイムの差異を曖昧にしたまま腑に落ちないまま先に進むと苦労するのは自分だとも思います。

実際、ベイズ理論は、義務教育で習う統計学の発想、理念、哲学とは異なり、またイメージしにくいものだと思います。

義務教育で習うスタンダードな統計学は、ネイマンとピアソン、という人たちが体系構築したもので、「ネイマン=ピアソンの頻度主義統計学」とか呼ばれているようです。
彼らが思いっきり糾弾して表舞台(学会)から一旦放逐してしまった、近年大復活を遂げているのが、ベイズという人が考えたベイズ統計学というわけですが、何が異なるのか?

ここは実際かなり哲学的な思索になるわけで、筆者自身は結構そういうことは突き詰めて考えないと先に進みたくないわけで、自分なりに考えた結果、多分ほかではあんまり言われていない考え方をシェアしたいと思います。

キーワードは、現実(という世界)、観測、条件付き確率です。

1が出る可能性が100%のサイコロは存在するか?(歪みもないのに)

という思考実験をしてみます。
厳密な議論はさておき「ネイマン=ピアソンの頻度主義統計学」では、歪みがないんだから、無限回数試行(サイコロふってみること)をすれば、大数の法則で確率1/6に収束するはずだ、これが「真の確率」である、みたいなことを論じます。まあ学校でだいたいこういう感じで習ったと思います。そういうことです。

一方で、ベイズ統計学では確率とは「観測された事象」によって決まるという考え方をしています。
1が出る可能性が100%のサイコロは存在するか?(歪みもないのに)
答えYes。
たとえば、買ってきたばかりのサイコロをふって10回連続で1が出ることはあります。(1/6)の10乗の確率でそうなります。しかしそれは「極まれでたまたま」であって、次は1じゃないだろうとか100回ふったらさすがに1が出ないだろう、みたいになるわけですが、100回連続でふっても(1/6)の100乗の確率で「ありえる」わけです。
年末ジャンボ宝くじを1枚だけ買って、1等が当たる確率は2,000万分の1らしいですが、1枚だけ買っても当たる人は当たるわけで、その人にとっては当選確率100%になるわけです。だって当たったんだから。

「確率」というのは、「ネイマン=ピアソンの頻度主義統計学」のように、そういう人らが「こうだ」と厳密に定義することも可能ですが、別の解釈も可能な余地があるように思えます。「ネイマン=ピアソンの頻度主義統計学」は「客観確率」、「ベイズ統計学」はここで少し例を出した雰囲気からなんとなくわかるかもしれませんが「主観確率」と呼ばれたりします。

数学っていうのはもちろん、そもそも人間と関係なくアプリオリに存在していて、プラトンが論ずるように「イデア」として「客観」として存在しているわけで、その意味ではこの「主観確率」っていうのは何?ってことになります。少なくとも自分はこの「主観確率」っていう分類表現がどうも気に食わない。じゃあどう解釈するか?

ポイントは「観測」です。現代物理学、量子力学を勉強していると、どうもこの「観測」っていうのが「やっかい」もの扱いされているとわかってきます。

量子力学は、シュレディンガー方程式で記述される波動関数の確率密度によって量子の存在確率が決まるんですが、人間が観測した時点で、その波動関数っていうのは「崩壊」「収束」して1個の点に決まります。まあ、確率統計で構築されている美しい理論が、人間が観測した時点で急にその確率っていうのがどっか行ってしまって「波動関数の収束」という摩訶不思議な現象が起こります。当時、超天才のフォン・ノイマンが、ここを徹底的に追求して、結局、量子力学の理論体系からは「波動関数の収束」なんて現象はどうやっても導出できない!ってことを数学的に証明してしまいます。理論は非常に美しくて整合性もある正しそうだ、でも数学的にありえないことが実際起こっている、結局「人間の意識が波動関数を収縮させる」ということを主張しました。現在では、まあ理由はどうであれ、とにかく収束する、追求しないという「コペンハーゲン解釈」というのがあります。今でも一線の物理学者の多数が支持している解釈かどうなのかは知りませんが、少し昔までは多分これが標準的な解釈だったんでしょう。

一方で、エヴェレットという人が「観測者だけ特別扱いで波動関数の確率の枠組みに入れていないのはおかしくない?」という至極当然の発想で、突き詰めたのが「エヴェレットの多世界解釈」です。
これはつまり、観測者自身も波動関数の確率的存在と考えれば、どこにも観測対象の波動関数の収束みたいなおかしなことが起こる余地はない、理論的に整合が取れている、ということです。
まあ、意識を創発する物質としての人間の脳という観測主体が、量子力学の理論どおりシュレディンガー方程式で記述されるままの波動方程式によって表現されている確率的存在であるならば、それぞれの分布局所で「観測対象が1点に収束している!」と対応する現象が起こってるんでしょ?じゃあそれで矛盾がないじゃない、という考え方です。

意識を創発する物質としての人間の脳という観測主体が確率的に存在している、観測される対象(客体)も確率的に存在している、それぞれ重ね合わさって、「観測対象が1点に収束している!」とそれぞれ辻褄があっている、ってことは、すなわち世界が複数重ね合わさって存在してるってことです。
まあ、普通は信じられませんよね。でも論理的に否定するのは不可能で、論理的にはむしろこっちの多世界解釈のほうがよっぽど辻褄があっています。そもそも「波動関数の収束」みたいな解決不能な問題が解決されている、ってことでこっちのほうが正しそうだ、と私は思うし、今時はかなり多くの(気の利いている)理論物理学者はコペンハーゲン解釈ではなく、多世界解釈じゃないんでしょうか?一般にこれは素朴実在論では「直感」に反する考え方なので、いろいろ理由をつけて否定する人もいるでしょうが、それは理性でもなんでもなく、結局否定することなんて不可能だということくらいのコンセンサスはさすがにできており、だからこそ「コペンハーゲン解釈」「多世界解釈」どちらでもすきな解釈でどうぞ?みたいなことになってるわけです。真実は多世界であったとしても、多世界間は相互作用なんてない(はず)なので、実験で確認することは不可能であり、すなわち反証可能な科学理論としては成立しません。だから科学「理論」の範疇でなく「解釈」の問題です。

多世界解釈は決定論です。一般に馴染みがある、思いっきり俗な言い方をすると運命論みたいなものです。最初からすべては決まっている。
Wikipediaでも

だが、20世紀になると、量子力学におけるコペンハーゲン解釈によって、宇宙は原子下のレベル、量子レベルであまねく確率的であるという説が有力となった。

などと書かれていて、「だから未来は決まっていない」「人間は自分の意志で自由に未来を書き換えられる!」というBackToTheFuture的な世界観がポピュラーなわけですが、ぶっちゃけ、そんな「自由意志」みたいな、物理法則を超越した魔法みたいな事象はないです。意思、意識はこのベイズ理論の先にある「強い人工知能」によって発現すると、現在ほとんどの研究者は確信しており、そうなったら「意識」というか「自己認識」と言う現象も数学的構造あるいは計算結果だと証明されることになるでしょう。

世界は量子力学によって確率統計的に記述されているが、波動関数のランダムな確率的な収束がおこって偶然に決まるのではなく、波動関数で表現されている統計値は宇宙に「もれなく全部」決定的に展開されており、我々はその一部のみを知覚する世界のひとつにいる、ということです。

「波動関数」っていうのはこの世に数学的構造としてひとつしかなくて、それが時間も空間も超越した多世界にわーっとまたがっている、広がっている、その局地局地がある世界のある時間、そしてそこに存在する我々、我々の意識、ということになります。そういうのがいっぱいある、ということです。これが多世界解釈。
コペンハーゲン解釈では、この観測できる世界がまず存在する、まあ素朴実在論の素朴な発想です。そこになんかしらないが、波動関数という数学的「近似」理論があるみたい、それがなんかわからないけど、なんかのきっかけで収束する。この世界にこの波動関数はひとつ!みたいなことになります。間違っていると思いますが。素朴だし。

とこういう「多世界解釈」「決定論」としての哲学的足場が私にはまずあります。
これを前提に「確率論」というのは当然解釈していくわけです。

「ネイマン=ピアソンの頻度主義統計学」の根本的な問題点は、素朴実在論に基づいた「この世界はたったひとつ!」という暗黙の了解、大前提があることです。だから「真の値」とは「神様だけが知っている値」とか、「真の値が存在するが、私達が知る事ができるのは、真の値に近いと思われる値、それがサンプルから計算した平均値や標準偏差だ」みたいな議論になります。まあ日常の主観的には「この世界はたったひとつ!」という気持ちで生活してもまったく問題は発生しないわけですが、数学で突き詰めて考えるときに、果たしてこういう大前提を無条件に暗黙の了解として受け入れて良いのか?といえば良くないと思っています。

多世界解釈を採択する私の世界観からすると、こういう「ネイマン=ピアソンの頻度主義統計学」による「真の値」とは、「時間も空間も超越した多世界にわーっとまたがっている、広がっている、「波動関数」としてこの世に数学的構造として存在している確率分布の最尤値」のことです。

我々がたまたまこの世界で、たまたま観測する、観測できる事象とは、無限の多世界に存在するうち、たまたま今ここで意識を創発していると感じている、という意識がある自分が観測した「今ここでの値」という限定された局所的な値でしかありません。

その「今ここでの値」というローカル値というのは、当然、シュレディンガー方程式の波動関数によって規定される確率分布のどこかにある一つの値であって、確率分布に従って「他にもいっぱい」「今ここでの値」っていうのが決定論的に最初から存在しているわけです。

もうちょっと平たく言うと、
1が出る可能性が100%のサイコロは存在するか?(歪みもないのに)
答えYes。

たしかに歪みがないわけですから、多数回試行すれば、1−6までかなり平均的に出るような「世界」のほうが多世界グループのなかでも圧倒的に多いでしょう。しかしながら、多世界が無限に広がっているわけで、たまたまこの「世界」は「なんだかよくわからないけど、このサイコロは歪みがないのに1ばかり連続して出る!」という世界かもしれません。

あなたが年末ジャンボ宝くじを1枚だけ購入して、「案の定ハズレた!」とあなたが思ってる世界のほうが圧倒的に多いわけですが、「なんだかよくわからないけど、当選したぞ!奇跡だ!」とおもっている世界は2000万分の1の確率で存在するわけです。どこかに。存在しない?なんで?2000万分の1の当選確率であるならば、フェアに考えてそういう確率分布になっているはずです。もちろん、その多世界のうち、「今そこにいるあなた」の脳も確率分布に従って波動関数の重ね合わせで存在しており、意識もそれに呼応しているわけで、その意識において、「なんだかよくわからないけど、当選したぞ!奇跡だ!」と感じる事象になっている確率は2000万分の1にすぎません。

ある事象ひとつをとっても、無限に存在する多世界は、ある波動関数で規定される確率分布ですから、その曲線の山の最も高いところが最も存在確率が高い、つまり世界の数が一番多いです。
そういう多世界のうち世界の数が一番多いだろう(世界の存在確率が一番高いだろう)っていうポイントを「最尤値」と呼びます。

簡単のために次元を落として、オモテウラのコインで考えます。(2面のサイコロっていうのと一緒)(最初からコインの例に統一すればよかったかもしれない)

ネイマン=ピアソンの頻度主義統計学では、オモテが出る確率θは五分五分、1/2=0.5ですね。

一方で、ベイズ統計学ではこんな「オモテが出る確率θは1/2=0.5」みたいな多世界の「最尤値」=「真の値」は初期設定では論じることは不可能です。科学実験としてそんな多世界の全部は到底観測不能だからです。

世界は量子力学の波動関数の確率分布ですべて記述されているのです。まあ、多世界のうち存在確率が一番高いのは、たぶん、θは1/2=0.5、となっている世界だろうね!みたいな確率分布議論しかできません。そして、この世界は、その一番存在確率の高い世界に落とし込まれている可能性が高いから、多分、この世界でもθは1/2=0.5が最尤値となってる確率分布なんじゃない?みたいなことです。

しかし、実際に試行してみて、連続でオモテしか観測されなかった場合、
「おいおい、どうやらこの今自分が生息してる世界は、超多数派のθ1/2=0.5が最尤値の世界のパターンじゃなかったようだ、珍しいね!」ってことになります。
宝くじの例で言い換えると、
「おいおい、当選確率2000万分の一の存在確率が超低い世界なのに、なんか知らないけど、実際にこの世界で当選しちゃったので、この世界はたまたまその存在確率が超低い世界だったみたい!」みたいなことが起こりうるわけです。

今一体何を考えているのか?というと、「確率の確率」を考えています。
ネイマン=ピアソンの頻度主義統計学では「世界はただひとつ」であり、
この世界の「真の確率」もただひとつ、であるわけですが、
ベイズ統計学は多世界解釈であるという見解では、「世界は無数に存在する」ので、
それぞれの世界ごとに、それぞれ確率が存在する、無数に、と解釈できます。

無数に存在するであろう世界のそれぞれの確率を俯瞰的にみて統計的に確率分布で考える、「確率の確率」「確率分布の確率分布」を考えるということがベイズ統計学では可能です。

コインを実際に試行してみて、連続でオモテしか観測されなかった場合は、その世界の観測値に従って
オモテしかでない確率、つまりオモテ確率100%、θ=1が最大値、最尤値になります。
ベイズ推定では、コイン試行の「確率の確率分布」はベータ分布(サイコロなら一般化された多変数のディリクレ分布になる)になり、二次元グラフに表すと、ある世界(この世界)のある時間(観測時点)で、観測結果がオモテ100%だった場合のオモテが出る確率θの分布は、

enter image description here

です。オモテ確率0%、θ=0のときの確率は0になっています。少なくとももう1回はオモテが出たという事象が観測されてしまっているわけで、オモテ確率0%、θ=0というのはもう「絶対にない」ということになります。

さらに連続してオモテが観測されたとき、確率θの分布は、

enter image description here

に変化します。

さらに3回連続でオモテが観測された確率θの分布は、

enter image description here

というように、オモテ確率θ=100%の度合いがどんどん強まっていくことが確認できます。

このまま、「たまたま」オモテしかでない世界だった場合、この延長でどんどん、θの何乗っていうのが1個ずつ増えていってオモテ確率θ=1グラフの度合いが急激になっていくわけです。

さて、仮に、もし次の試行でウラが出たらこの確率分布はどのように変化するでしょうか?

enter image description here
 
こうなります。

もう、オモテ確率θ=100%というのは、実験、観測で少なくとも、もう1回ウラが出てしまったので、
オモテ確率θ=100%っていうのは「絶対ありえない」0%だ、言い換えると、θ=1.0となる確率はゼロである、というように確率分布が更新されてしまいました。とはいえ当初の実験で3回連続でオモテが観測されていたので、なおオモテ確率のほうが高い分布となっています。

それを打ち消すように、さらにウラが連続して9回出た場合。
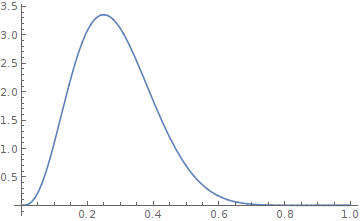
enter image description here

というように確率分布は観測結果に応じて変化していきます。

さらに試行を重ね、オモテ30回、ウラ30回と均等に出るという事象が観測された場合。

enter image description here

かなり「ネイマン=ピアソンの頻度主義統計学」が云うところのいわゆる「真の値」である確率θ=1/2=0.5が際立った確率分布となっています。

多世界が「観測」によって波動関数が収束したように見えることは、ベイズ更新の確率分布をグラフに表したときの領域分割として幾何的にイメージして理解できます。

念の為にまず超基本的な確率のことがらと用語を復習しておきましょう。

P(A,B) = P(A)  x P(B|A)

「同時確率」P(A,B)は、
事象の確率P(A) に
「条件付き確率」P(B|A)を掛ければ求められる(確率の乗法定理)。

言い換えると、
事象の確率P(A)に掛ければ
「同時確率」P(A,B)になるような確率のことを
「条件付き確率」P(B|A)と定義する。

P(B|A) = P(A,B) / P(A)  

条件付き確率と確率の乗法定理は、
定義として表裏一体で同じ概念をそれぞれ逆方向で命名したものです。

非常に単純なことしか言ってないのですが、非常に単純だということがわかりにくい人は、
前回の記事のトランプの例を参照すれば良いでしょう。

カードが黒 ■
カードが赤 □
と表記し、
カードのマーク(スート)の強さは
♠ > ♡ > ♢ > ♣なので、
上位2つを ↑
下位2つを ↓
とグループわけして表記することにする。

|   | ■ | □ |            
+---|---|---+
| ↑ | ♠ | ♡ |
| ↓ | ♣ | ♢ |

Aはカードの色2択(図の横軸)
Bはカードのスートの強弱2択(図の縦軸)

カードの色、黒赤同じ割合の2択の事象の確率

P(A)=1/2

で、
カードの色が確定した事象について、さらにそこから、
スートの強弱の同じ割合の2択の事象があるので、
条件付き確率

 P(B|A) =1/2

となっています。ここまでが大前提。
さて、

♠というスートの存在確率は、
カード色=黒
その上なおかつ
カード強弱=強い
という「条件つき確率」からの「同時確率」で表現できます。

P(A,B) = P(A)  x P(B|A)
1/4 = 1/2 x 1/2 

そしてよくよく考えてみると興味深いことに、
カードの色A、スートの強弱Bを入れ替えてもまったく同じ論理で、

♠というスートの存在確率は、
カード強弱=強い
その上なおかつ
カード色=黒
という「条件つき確率」からの「同時確率」で表現できます。

P(A,B) = P(B)  x P(A|B)

なので、「同時確率」P(A,B)について接続してまとめると

P(A)  x P(B|A) = P(B)  x P(A|B)

4つの確率の関係式があります。
簡潔なこの4つの確率の関係式から深淵な理論が導出されてしまう。

P(B|A) = P(B)  x P(A|B) / P(A)

単に移項しただけなのですが、
この式の形が「ベイズの定理」と特別扱いされて呼ばれています。

ベイズの理論は式を見ての通り徹頭徹尾「条件付き確率についての理論」であると言えます。
ベイズの理論を理解する事は、「条件付き確率」とは何か?を理解することと同じです。
もちろん、こうすればこうなる、ほら使えるでしょ?と道具の使い方だけを学ぶことは可能ですが、
道具の使い方を理解していることは理論の理解ではありませんし、後々苦労するし応用もまったく効かないでしょう。

じゃあ、「条件付き確率」っていうのは多世界解釈において一体どういう意味なんだろう?
と考えてみると、いやいやそれ以前にそもそも「確率」ってなんのことだったんだろう?
と再確認する作業が必要です。

ものごとが「起こる」か「起こらないか」というときに、「可能性」という言葉を使います。
ものごとが起こらないことが観測され確定したときに「可能性が消えた」という言葉遣いをします。

これはすなわちある時点まで不確定であったものが、確定した、ということで、最初から論じている量子力学のコペンハーゲン解釈(この世界は眼の前にある世界唯一つ)で、波動関数がなんか理由がわからないけど、追求するのはあきらめてとにかく事実として収束する、という現象がある、という意味そのものです。(素朴実在論)

一方で、多世界解釈においてはそもそもそんな不確定事象などは存在せず、最初からぜんぶまるごと決定論的に決定されて世界はただそこに存在していて、我々が観測して「事象が確定した!」と思い込んでいるのは、実際のところ我々の脳もその可能性の一つの世界に波動方程式の確率分布のひとつとして存在しており、それぞれの多世界で「観察」した結果「事象が確定した!」と思っているという哲学的立場でした。(プラトニズム)

別の言い方をすると、可能性は消えない、ひとつの可能性を観測した場合、また別の可能性を観測している世界が無数に存在する、世界がそこで分岐したとみなされる。

「分岐」するというと動的な印象がありますが、実際は最初からそのように決定されている数学的構造です。波動関数がそのような確率密度の分布となっており、そのどの部分で切り取って見るか?ということに対応します。

確率とは事象の存在の割合です。世界の存在確率=多世界に含まれている、ある多世界の割合。’
多世界の分量は無限個ある(多分)ので、世界の量は割合でしか表すことはできません。
ブラウザの利用総数なんてわからないけれども、ブラウザ利用シェアは自サイトのアクセス分析から割り出せるみたいなことです。
Chrome7ブラウザからのアクセスは全アクセスのうち70%みたいに。
「こんなパターンの世界が全多世界のうち70%のシェアを占めている」
「こんなパターンの世界の存在確率は70%=0.7である」ということになります。

こういう多世界解釈の世界観でベイズ理論はどう解釈できるか?ということを追求してみます。

ベイズの定理

P(B|A) = P(B)  x P(A|B) / P(A)

ベイズ理論風に記号を書き直す
AをEvidence(証拠、観測値、データ(の確率分布))
BをHypothesis(仮説(の確率分布))
と書き換えて、

P(H|E) = P(H,E) / P(E)  
       = P(H) x P(E|H) / P(E)

この確率と条件付き確率の関係式を多世界解釈の立場から「理解」して「イメージ」できることを目標とします。
ベイズの定理の式がこうだから論理的にこうなる、という説明の組み立てはしない、すべきではないので、いったんこの目標を確認した上で、最後に統合します。

すでに上のほうで一回説明を試みた、コイン投下の試行について思考実験します。
まず多世界があります。その無限に広がる多世界のうち「今これからコインの実験をしよう!」とあるコインを用意した世界がそのなかに存在しています。そしてもちろん「コイン?なにそれ?」というまったくこの試行に無関係の世界がその他無限に存在していますが、そこは関係ないので今回切り捨てます。
あるコインについてだけの多世界にまず絞り込みます。これを「全事象」と初期設定します。わかりますね?

これからそのひとつのコインに関する多世界にまたがって思考実験していくわけですが、あるひとつの世界のなかで科学的な実験を行った場合、観測可能なのはたかだかその世界に所属しているコインひとつだけです。
それ以外の他の世界に所属している科学実験のことは絶対に観測不可能です。知る手段はありません。それぞれの世界の観測は独立しています。

ただし、量子力学がものがたるように、世界は量子力学の波動関数の確率分布ですべて記述されています。数学を通じて多世界にまがたる確率分布の議論をすることが可能ですし、それをやってるのが量子力学であるといえます。

それぞれの世界にはそれぞれの世界特有の観測結果や確率がありますが、多世界なので、前述したとおり、Chrome7ブラウザからのアクセスは全アクセスのうち70%みたいに、
「こんなパターンの世界が全多世界のうち70%のシェアを占めている」
「こんなパターンの世界の存在確率は70%=0.7である」という話ができます。
「確率の確率」です。もうちょっというとシェアの話なので、確率の確率分布の話ができます。

逆に言うと、多世界について我々が数学を通じて話せるのは、多世界の「確率の確率分布」以外にはありません。その話しかできないし、その話だけを徹頭徹尾しているのがベイズ統計学です。

あるコインについてのみ切り出した多世界の全事象を以下のように表現することとします。
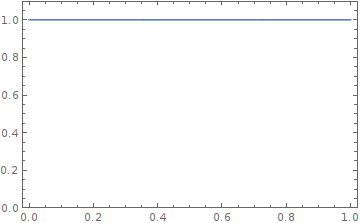
enter image description here

横軸は0-1.0 の確率
縦軸も0-1.0 の確率
確率の確率のグラフです。
全事象は確率100%なので、掛け合わせると1.0になっています。

このグラフでは、確率の確率分布が視覚的に把握できます。
現在よく見ると、y=1 で直線が引かれており、
xとyともに0-1区間の領域で四角形になっていますね。
この領域があるコインについてのみ切り出した多世界の全事象で1となっています。
全事象のシェアは100%ということです。

ここで、コインを1回投げます。
ある世界ではオモテが出た。ある世界ではウラが出た。
コインを投げると、その観測結果を境界として多世界が分岐します。

enter image description here

このように分割されます。

y=x という直線で四角形の領域が半分に分割されました。
1回目の試行でオモテが出たほうの多世界グループと
1回目の試行でウラが出たほうの多世界グループと
に多世界全事象が半分に分割されました。

右下の三角形の領域がオモテ世界で、この世界の目線からすると、
1回目の試行でオモテが出た、という観測結果が確定したことにより、
1回目の試行でウラがでる、という「可能性は消滅した」ということになります。

しかしながら、「可能性は消滅などしない」というのが多世界解釈でした。
オモテ世界から消滅したように見えた、可能世界であるウラ世界は、
このグラフの左上の三角形の領域です。
彼らからすると、可能性が消滅したように見えるのはむしろオモテ世界のほうです。
 
全領域
y=1
enter image description here

から
オモテ世界の領域
y = x
enter image description here

を引き算してやると、
ウラ世界の領域
y = 1 - x 

enter image description here

左上の三角形の領域(の面積)がちょうど上下ひっくり返って明示的な確率の関数として計算して表現できます。
ちなみにこれは全領域1のうちの割合なんぼという話なので、
「確率の密度」という解釈ができるので、「確率密度関数」と呼ばれています。

全領域1のうちの割合なんぼという「確率の密度」を総計していけば、当然
全領域1のうちの割合なんぼが計算できるので、
「確率密度関数」を積分すれば確率になります。

2回目の試行をします。
1回目の試行と2回目の試行はコインを投げるということでまったく同じことの繰り返しです。

つまり、世界をコインを投げることによってまた

enter image description here

このように分岐させてしまうわけです。
ただし!分岐するのは、すでに分岐してしまった世界の延長で分岐します。すでに分岐してしまった世界がふたたび統合されたり、なかったこと、チャラになることはありません。最初から決定されているであろう多世界の分岐構造をひたすら辿っていく確認作業をやっているだけなので、分岐をたどっていったはずなのに、元の分岐がチャラになったという動的な変更は起こりえない、ということです。

enter image description here

を前提とした上で、

enter image description here

で、さらにまた分岐する。これはすなわち「条件付き確率」のアレをやっているということです。

P(A,B) = P(B)  x P(A|B)

前提となる事象に「条件付き確率」を乗算すれば、「同時確率」すなわち「分岐後の世界の確率」が得られる。

実は最初に、
全領域
y=1
enter image description here

に「条件付き確率」
y = x
enter image description here

y = 1 かける xと乗算した結果、
y = x
enter image description here

になっていたのでした。

すでに世界は、
1回目オモテ世界
1回目ウラ世界
のふたつに分岐されてしまっていますが、全パターンの分岐を辿るのはしんどいので、
当面、1回目オモテ世界の延長の分岐だけを探ることとします。

1回目オモテ世界の延長で、
1回目オモテ世界を前提に、条件付き確率の乗法定理を適用し

P(A,B) = P(B)  x P(A|B)

今回さらにまたxを乗算するので、

で分岐(グラフが分割)されます。

enter image description here

y=x で表される確率密度関数の領域をさらにまた、y=x で表される確率密度関数で表される条件付き確率という「割合」をもって分割したら、乗算して二次関数となって分割されることになります。

1回目オモテ世界の延長で、
オモテ連続2回世界は、一番右下の三角形が凹んだような領域に分類されます。

これは、最初の方で説明した、


さらに連続してオモテが観測されたとき、確率θの分布は、

enter image description here

に変化します。


と同じですね。係数の3がないのは、今回分岐大元のコイン多世界全事象=1のままで考えているからです。これはあとでどうせまた説明することになります。

じゃあ、その世界から可能性が消滅したように見えて実は別の世界に分岐されている、
1回目オモテ世界
2回目ウラ世界
という世界は、グラフ中央の三日月みたいな領域に分類されています。

すでにやったように、単なる引き算でもうちょっと明示的に確率密度関数として表現できますから、

y=x から 二次関数を引き算してみる、

変形すると

これもどっかでみたことありますね?

enter image description here

例のベータ分布になってしまいました。
1回目オモテ
2回目ウラ
というイーブンの観測結果であると、最尤度0.5のベータ分布です。

ここで、念の為に確認ですが、
我々が数学を通じて多世界について語れるのは、せいぜい確率の確率分布でしかありません。
このように多世界の初期設定をして、そこから観測結果に応じて多世界の分岐をたどっていったとしても、その世界自体も、また次なる分岐に備える、確率分布で記述されている多世界でしかありません。

多世界→多世界→多世界→多世界→多世界→

と延々と連なっているので、事象観測後の分岐した世界で語れるのは、
分岐前と同じような確率の確率分布のはなしだけです。

さて、さらに多世界分岐の探求をつづけます。

で分岐(グラフが分割)

enter image description here

されましたが、そのうち、オモテ連続2回世界の延長の分岐を探ります。
グラフでいうと、一番右下の三角形が凹んだ領域のことです。

オモテ連続2回世界の延長を前提とし、
また同じ試行の
「条件付き確率」
y = x
enter image description here

によって世界が分割されるので、

enter image description here

となります。

オモテ連続2回世界の延長で、分岐したもう片方の
3回目ウラ世界は、
グラフの一番細い三日月みたいな領域に分類されています。

オモテ連続2回世界ー 3回目オモテ世界 という引き算で確率密度関数を求めると、

変形すると

enter image description here

これも当然のごとくベータ分布になっていますね。

もうあとは同じことの繰り返しが延々と続きます。
そしてすべての分岐のパターンで限りなく世界が分岐、分割され細分化していきます。

最初の方で確認した


それを打ち消すように、さらにウラが連続して9回出た場合。

enter image description here

というように確率分布は観測結果に応じて変化していきます。

さらに試行を重ね、オモテ30回、ウラ30回と均等に出るという事象が観測された場合。

enter image description here


以上のような確率分布になるような観測結果をもつ世界はこの全事象の分岐(領域の分割)の先のいずれかのひとつとして存在しています。

だいたい世界観のイメージは伝わったと思いますので、観測による多世界の分岐現象がベイズの定理でどう表現されているか確認します。

Evidence(証拠、観測値、データ(の確率分布))
Hypothesis(仮説(の確率分布))

P(H|E) = P(H,E) / P(E)  
       = P(H) x P(E|H) / P(E)

というものでした。

モデルケースとして、以下を再掲します。


で分岐(グラフが分割)

enter image description here

されましたが、そのうち、オモテ連続2回世界の延長の分岐を探ります。
グラフでいうと、一番右下の三角形が凹んだ領域のことです。

オモテ連続2回世界の延長を前提とし、
また同じ試行の
「条件付き確率」
y = x
enter image description here

によって世界が分割されるので、

enter image description here


以上を例にとって考えてみると、

1.事前確率(分布)

 観測によって分岐される前の前提となる世界の分布
 この場合は、オモテ連続2回世界がP(H)という事前確率分布になっている

2.観測(分布) 一般的には「尤度(Likelihood)」という用語になっている

 観測による分岐前を前提とした条件付き確率の分布、
 事前確率(分布)であるP(H)を前提としたときの観測データEvidenceの確率分布
 この場合は、試行データ=オモテ

3.事後確率(分布)


 観測データEvidenceによって分岐した後の世界の確率分布、
 これは、観測データEvidenceを前提とした条件付き確率の分布として表現されている
 この場合は、オモテ連続3回世界の確率分布が得られた

さて、最後に、ベイズの定理

P(H|E) = P(H) x P(E|H) / P(E)

4つ目の確率分布である、 P(E)です。
初見では
「これこそがEvidenceの確率なのだから観測のなにかの分布なんだろう?」
と勘違いしてしまいますが、すでに確認したとおり、観測に該当するのは
世界が分岐する前の、事前確率分布P(H)を前提とした、
条件つき確率分布であるP(E|H)のほうでした。

今回、多世界解釈に基づいて、
あるコインを試行するときの多世界の全部を全事象1として、
それが観測によって分岐、分割されていくという現象を調べました。

その結果、世界が分岐し、確率密度のグラフ領域が分割された先のひとつには、
たとえば、オモテ1回ウラ1回のイーブンな観測が得られた世界の確率分布が、

enter image description here

このようになっていることも確かめられました。

この確率分布は、あくまで、
あるコインを試行するときの多世界の全部を全事象1としたときのグラフのうち

enter image description here

中央の三日月のような領域として分割された割合です。

さあここで、よくわかった、でももう多世界全部の事象のことは関係ないや、この分岐した世界ローカルで考えたい!という立場を取る方針にした場合、
あるいは、
多世界分岐後の新たなる多世界の出発点として、この分布こそが今ここにあるコイン試行世界のすべてであり、原点である、という方針にした場合、
つまり、
多世界の全事象、全領域

enter image description here

ではなく、
多世界の全事象、全領域

enter image description here

という初期設定にリセットしたい場合、
この確率密度関数の積分値が1となるように調整しなおさなければなりません。

これを「正規化(Normalization)」と言い、これは量子力学の波動関数でも同じ操作が必要になります。確率っていうのはしょせん、何かを基準とした割合のことなんで、どこを基準に取るか?っていうので値を調整する必要がでてきます。
ちなみに、ベイズ理論において、この確率密度関数の積分っていうのがめちゃくちゃ面倒くさい場合が多くて、うまい近似の手法でやったり、代数的な計算はあきらめてMCMCというモンテカルロ・シミュレーション(サンプリング)の手法でやったり、いろいろ工夫があってこういう積分の計算方法だけで一大研究課題となっています。

今回のケースでは、世界をベータ分布の連鎖で分割していったので、かなりはっきりとした代数のルールがあり、積分する必要はありません。(自然な共役分布)
しかし、その代わり、その操作の履歴データが必要となります。

というベータ関数にまつわる公式を利用すると、
全多世界事象1のうち、

enter image description here

三日月部分の世界の領域の割合は、1/6である、ということがわかります。
これが、全事象1のうちEvidenceの割合なので、P(E)の値となります。

じゃあ、P(E)が全事象となるようにリセットしたい、正規化したいならば、
全事象1のうちEvidenceの割合であるP(E)で割り算すればリセットできますね。

を正規化すると、


enter image description here

係数が1から6に増えたことによりグラフの領域が拡大されたことが確認できます。

4.全事象のうちの事後確率(分布)の確率

P(E) とは最初設定した全事象にたいする、事後分布P(H|E)の確率
これは多世界分岐(ベイズ更新)のすべての履歴が必要となる。
あるいは履歴なしでは積分して1になるような値を求める必要があるので、計算が一番やっかい。
P(H|E)を全事象としてリセットする正規化のために必要。

ベータ分布で

のモデルケースでは、

となり、

のモデルケースでは、

になる。

以上で、

ベイズの定理

P(H|E) = P(H) x P(E|H) / P(E)

の4つの確率(分布)がすべて出揃いました。

ある確率分布で記述されている多世界があり、データを観測し、それに応じて世界が分岐し、確率(シェア、領域の割合)が分割され、分岐後の多世界がそれぞれ持つ確率分布を得る、ということをベイズ更新(Bayesian Updating)といいます。量子力学の多世界解釈すれば、ということですが。

いずれにせよ、この観測結果を反映するベイズ更新が連鎖構造になっています。
量子力学の確率分布であらわされる多世界が観測結果を反映して分岐している構造と1:1に呼応しています。


さらに試行を重ね、オモテ30回、ウラ30回と均等に出るという事象が観測された場合。

enter image description here


という様に、係数がめちゃくちゃ大きな値となっているのは、そもそもの全事象から世界が分割されまくった確率分布をリセットして正規化したからだ、という自然な解釈ができます。

以上は、コインの試行についてベータ分布になる、というのはどこにでも普通に書かれている知見ですが、量子力学の確率理論、特に多世界解釈で、ベイズ理論を俯瞰してみればどういう意味だろう?というのは筆者のオリジナルです。別にどこか他のどなたが同じ解説をしているかもしれませんが、よくわかりません。
特に、ベイズ理論を確率分布に適用した場合についての尤度(Likelihood)について納得できる解説が見当たらなかったのですが、こう俯瞰したら納得できたということです。また、ベイズ統計学について、「主観確率」であるとか「あいまいな推定ができる」とか、「信念の度合いが表現できる」とか事例を示されたとしても、それが数式のイメージとして腑に落ちることはありませんでした。
また、世紀をまたいで継続している、「ネイマン=ピアソンの頻度主義統計学」とベイズ統計学の論争は、根本的にはこのコペンハーゲン解釈と多世界解釈の問題があると考えています。
そして念の為ですが、今回書いたような多世界解釈の哲学的立場は、素朴実在論では到底受け入れられないために不当な心理的反発を招きやすいのですが、これはもちろん私の独自哲学でもなんでもありません。今回あくまで多世界解釈の哲学的立場をそのまま援用してベイズ統計学を解釈してみた、という論理的帰結にすぎません。量子力学において波動関数(確率密度関数)で量子の存在確率が定まる、それは観測という行為にリンクしているというのは、ベイズ更新の特徴そのものであり、照らし合わせてみると案の定自然に解釈できた、ということにすぎません。

基本的に義務教育あるいは高等教育であっても多世界解釈を教えることは「何かと面倒くさい」ことのようで、理由とすれば素朴実在論的世界観が妨害しているとしか思えないのですが、その一方で素朴実在論と相容れない相対性理論、量子力学は学習する必要はあります。

その際、いずれにせよ「観測の結果、可能性が消えた」と普段発している言葉の意味はいったいどういうことなのか?というのは別段ベイズ統計学に限らず義務教育で習う局面であっても誰でもが一度は考えたことがあるかもしれません。「観測の結果、可能性が消えた」というのは量子力学の波動関数の収束に他ならず、これはコペンハーゲン解釈では理論的に破綻していることは数学的に証明されています。理論内からけして導出できない現象について理論の外に大業な名前をもって原理の追加する、ことがまかり通るのであればあらゆるオカルト現象も同様に、なんか大業な名前をつけてそういう原理の法則であると言ってしまえばすむわけなので、これは科学ではないだろうと訝しく思っています。

この「観測の結果、可能性が消えた」というのは、実際ベイズ更新の解説で多用されていること、あと、ベイズ理論から展開されるベイズ統計学的機械学習が最近主流になりつつありますが、次にどの方向に進めばスムーズに楽しくすすめるのか?過去の自分の経験を踏まえながら少し紹介します。

今回紹介したとおり、ベイズ推定はデータを観測して条件付き確率で確率分布をアップデートする連鎖構造になっています。この簡潔な連鎖構造を応用していくらでも複雑な構造化が可能なのですが、視覚的に表現する体系が確立されていて、グラフィカルモデルといいます。
グラフィカルモデルのノードひとつひとつが条件付き確率からのベイズ推定であり、グラフィカルモデルのネットワーク構造はベイズ推定のネットワークです。
矢印ある有向ならばいわゆるベイジアンネットワークであり、無向ならマルコフ確率場です。
マルコフ確率場とだけ聞くとなんか面倒くさそうだな、と思うんですが、構造としてはこちらのほうがベイジアンネットワークよりもシンプルで、まあベイズで連想記憶とかやる場合はこちらを確実に使うでしょう。あとコンピュータビジョン。

逆にグラフィカルモデルの「ことば」が理解できないと、たいていの本を読むとき必ず挫折してしまうので、ベイズの基本を徹底的に学習したその次はグラフィカルモデルに進むというのがおすすめです。

PRMLはベイズ統計学に基づいたグラフィカルモデルと生成モデルの体系的な説明が以前から評価を得た大きな理由だと思いますが、

著者のビショップ教授もグラフィカルモデルは導入として特別扱いしているようで、

PRMLの8章グラフィカルモデルだけは無償でPDFダウンロードできるようになっていたり、
http://research.microsoft.com/en-us/um/people/cmbishop/prml/
Contents list and sample chapter (Chapter 8: Graphical Models) in PDF format.
http://research.microsoft.com/en-us/um/people/cmbishop/prml/pdf/Bishop-PRML-sample.pdf

サマースクールでもその無償PDFをテクストとして、数学とりのぞいたバージョンの導入レクチャーをやっていてYouTubeで閲覧できます。見なきゃ損のコンテンツ。
講義のスライドもダウンロードできます。
http://mlss.tuebingen.mpg.de/2013/bishop_slides.pdf

非常にいたれりつくせりで、英語も聞き取りやすいのですが、耳障りが良すぎて寝る人が多い気がします。

Graphical Models 1 - Christopher Bishop - MLSS 2013 Tübingen
https://www.youtube.com/watch?v=ju1Grt2hdko

Graphical Models 2 - Christopher Bishop - MLSS 2013 Tübingen
https://www.youtube.com/watch?v=c0AWH5UFyOk

Graphical Models 3 - Christopher Bishop - MLSS 2013 Tübingen
https://www.youtube.com/watch?v=QJSEQeH40hM

このビショップ講義でも、グラフィカルモデルの基本としてのベイズ推定で「可能性が消える」話をたくさんしています。上のスライドみれば多分それはすぐわかるでしょう。

あとYoutubeで
Graphical Modelsで検索すれば、この界隈の著名人によるグラフィカルモデルの講義が沢山あります。Daphne Kollerとか。
https://www.youtube.com/watch?v=WPSQfOkb1M8&list=PL50E6E80E8525B59C
こっちは「長い」膨大な量で自分もまだ全部見れていません。

もちろん、前回紹介したサイモン・プリンスの
「ベイズ推定とグラフィカルモデル:コンピュータビジョン基礎」

もこの流れとなります。これも実質日本語訳の秀逸なオンライン講義が広島大のToru Tamaki 先生のレクチャーで見れるのでした。実際これはオンライン講義のほうがわかりやすくて、本読むのより随分楽です。

最近多いですねこういう優良な無料学習コンテンツが。
こういう秀逸なコンテンツを複数あわせて読む、聞く、見ると、多分最短で結構なところまで進めるんじゃないでしょうか。

本は速読したり、スキャン的な読解が可能で、内容が薄いとオンラインビデオチュートリアルなんかより本のほうが便利なんですが、思ったのはこういう一般にはとっつきにくい内容であるほど、著者は書籍より内容を一般向けに噛み砕いて非常に熱心に親切に教えようとする人が多いってことです。ああこれならもう本文読まなくていいんじゃない?という感じだったり、そう思ってから本文読むと、楽に読めたり、もちろん数式などはさっきのPRML8章みたいに、書籍には書いてあるみたいなことがあるんですが、どっちにせよ先にオンライン見たほうが良いと思います。

2016年3月9日水曜日

ベイズ導入とベイズ統計的機械学習参考書の紹介など

最近の機械学習のあらゆる教科書に必ずといって良いほど、最初のほうの章を割いて解説(紹介)されているのがベイズ統計学です。

ベイズ理論は簡潔な「ベイズの定理」から展開される非常に美しい理論体系で、
それゆえrobust(堅牢)で応用範囲が想像を絶するほど豊かです。
昨今もろに統計学的データサイエンス化してしまった機械学習、人工知能の研究の根幹となる理論であり、実用、応用で道具として使えればそれで良いというノリでさらりと終わらされてしまう(と自分は見てて思う)のはもったいないと思いつつ、巷の説明が非常に難解なので、ベイズ推定の概念の導入の導入として、考えうるかぎり一番かんたんな説明を試みます。

トランプのカードを考える。

カードが黒 ■
カードが赤 □
と表記し、
カードのマーク(スート)の強さは
♠ > ♡ > ♢ > ♣なので、
上位2つを ↑
下位2つを ↓
とグループわけして表記することにする。

|   | ■ | □ |            
+---|---|---+
| ↑ | ♠ | ♡ |
| ↓ | ♣ | ♢ |

ジョーカーを除外した13x4=52枚のデッキからカード1枚引いたとき、
カードが♠である確率を`
(♠)
と表記することにする。
♠♡♢♣のうち♠である確率は
(♠) = 1/4

カードが■である確率は、
(■) = 1/2

カードが↑である確率は、
(↑) = 1/2

♠は、■かつ↑なので、
同時確率(♠) = (■∩↑)

カードが■のとき、それが♠であるという、条件付き確率
(♠|■) = 1/2
カードが↑のとき、それが♠であるという、条件付き確率
(♠|↑) = 1/2

まとめると、  
(♠) = (■∩↑) = (■) x (♠|■)   
            = (↑) x (♠|↑)
(1/4)       = (1/2) x (1/2) 
            = (1/2) x (1/2)

移項すると、
(♠|■) = (♠)  / (■)  
もしくは、
(♠|↑) = (♠)  / (↑) 
という関係が成り立つ。 
(1/2) = (1/4)/ (1/2)

これは、デッキからカード1枚引いたとき、
そのカードが♠である確率
(♠) = 1/4
が、裏向けたまま「カードの色は黒(■)ですよ」と情報を与えられたことにより、
可能性は、♠♣に限定されてしまい、
カードが■のとき、それが♠であるという、条件付き確率
(♠|■) = 1/2
に収束したと解釈できる。

(♠) = 1/4
という「事前確率」が
(♠|■) = 1/2
という「事後確率」へと更新された現象を
「ベイズ更新」と呼ぶ。

同じように、デッキからカード1枚引いたとき、
そのカードが♠である確率
(♠) = 1/4
が、裏向けたまま「カードのマークは上位(↑)ですよ」と情報を与えられたことにより、
可能性は、♠♡に限定されてしまい、
カードが↑のとき、それが♠であるという、条件付き確率
(♠|↑) = 1/2
に収束したと解釈できる。

もう少し複雑なケース。

アウトレットセンターのある店舗で、
顧客の購入動向を統計的に分析することにした。
店舗に立ち寄る顧客が商品購入する確率は10%である。

購入する場合を  $
購入しない場合を ~
と表記すると
($) = (0.1)
(~) = (0.9)
となる。

商品購入する顧客が店員に声掛けする確率は 70%
商品購入しない顧客が店員に声掛けする確率は 20%

顧客が店員に声掛けする事象を ☻
顧客が店員に声掛けしない事象を ☹
と表記すると、
商品購入確率からの声掛けの条件付き確率は、

(☻|$) = (0.7)
(☹|$) = (0.3)

(☻|~) = (0.2)
(☹|~) = (0.8)
となる。

|   |  $  |  ~  |           
+---|-----|-----+
| ☻ | $∩☻ | ~∩☻ |
| ☹ | $∩☹ | ~∩☹ |

という4パターンの組み合わせを考慮しながら、
以下のように、すべての確率を洗い出すことができる。

($∩☻) = ($) x (☻|$) = (0.1)  x (0.7)  = 0.07
      = (☻) x ($|☻) = (0.25) x (0.28) = 0.07

($∩☹) = ($) x (☹|$) = (0.1)  x (0.3)  = 0.03
      = (☹) x ($|☹) = (0.75) x (0.04) = 0.03

(~∩☻) = (~) x (☻|~) = (0.9)  x (0.2)  = 0.18
      = (☻) x (~|☻) = (0.25) x (0.72) = 0.18

(~∩☹) = (~) x (☹|~) = (0.9)  x (0.8)  = 0.72
      = (☹) x (~|☹) = (0.75) x (0.96) = 0.72

このうち、たとえば最初の式、
($∩☻) =
($) x (☻|$) = (☻) x ($|☻)
という条件付き確率の関係性に着目して、
($|☻)  = ($)   x (☻|$) / (☻)
(0.28) = (0.1) x (0.7) / (0.25) 
と整理しなおしてみる。

左辺の($|☻) は、
顧客が店員に声掛けした場合の商品購入確率という条件付き確率である。

ある顧客が入店した際に、
「彼女が商品を購入するかどうか?」という確率は当初
($) = (0.1)
であったのが、
彼女が店員に声掛けした、という事象が確定した途端に、
彼女の商品購入確率($)が、声掛け(☻)の情報獲得によって
($|☻) = (0.28)
つまり、10% → 28% にupdate(更新)された、と解釈できる。
これがBayesian Updating「ベイズ更新」である。

($)→(Hypothesis)仮説
(☻)→(Evidence)証拠・データ
とし、
($|☻) = ($) x (☻|$) / (☻) をそのまま
(H|E) = (H) x (E|H) / (E) と書き換え、さらに
Probability(確率)のことであると明示する記法で
P(H|E) = P(H) x P(E|H) / P(E) 
と定義されていることが多い。(ベイズの定理・ベイズ推定)

P(E|H)は、Likelihood(尤もらしさ)、日本語では「尤度(ゆうど)」と呼ばれている。

P(H|E) = P(H) x P(E|H) / P(E)
で、
P(H)はPrior、日本語では「事前確率」
P(H|E)はPosterior、日本語では「事後確率」

Posterior ∝ Prior x Likelihood
の関係が成り立ち、何度もUpdateできる。

ベイズ更新の繰り返しを利用して、事象の確率を推定することをベイズ推定と呼ぶ。

各パラメータには、確率だけでなく、確率分布、確率の確率分布、
さらに「確率分布」も確率変数と見なして、確率分布の確率分布、
など柔軟に適用でき自由度が無限に高い。

導入記事おわり。

以下、ついでに随想と参考書の紹介。

ではそもそも最初の「事前確率」はどうするのか?というのは、実は一大問題で、ベイズ理論がデータサイエンス、機械学習と結びつく際の根幹となる問題。
おそらく、昨今注目されている深層学習(ディープラーニング)(というバズワード)もこのベイズ更新の事前確率の初期値の問題に還元されてしまいます。

ディープラーニングって何がディープなのか?というと、要するにディープな多層構造のニューラルネットワークであるということで、
畳み込みニューラルネットワーク(Convolutional Neural Networks: CNN)
ディープボルツマンマシン(Boltzmann machine)などで構成されています。
ボルツマンマシンも、ホップフィールド・ネットワークで、大元はアソシアトロンで、ととにかく、まだこの段階では「ニューラルネットワーク」全開。
しかし、ニューラルネットワークという脳のニューロン、シナプスのモデル化は、もうまもなくすべてベイズ理論に還元されてしまって「古典化」するとしか思えないし、多分そうなります。

ニューラルネットワークはどこへ行った?

自分が機械学習というか人工知能に興味を持って勉強し始めたのは、そもそもは小学生のころ「マッチ箱の脳(AI)」をBASICで実装したり、ということからはじまりますが、もうちょっとちゃんとした本を読んだのは、平成元年のころ、さっきのアソシアトロンの発案者のひとり中野馨 先生が監修した『入門と実習 ニューロコンピュータ』

というものでした。当時、日本語では多分この本くらいしか機械学習の本なんて存在しなかったと思います。
この本にはガッツリ脳のニューロン、シナプスのによる学習機構のこと紙面の半分くらいを割いて書かれていました。学習とは、脳のシナプスの可塑性によって成し遂げられる、シナプス可塑性はヘッブの法則がある、ということで、現在までの機械学習の研究の多くはこの系譜にあります。アソシアトロンはもろにこのヘブ則をモデル化して連想記憶を実現したものです。

そもそも最初は、脳のシナプスの可塑性をモデル化した形式ニューロンが神経生理学者によって提唱され、これはチューリング完全の計算能力を持つ、バラ色の未来が予期されるということで、単純パーセプトロンが実装されたわけですが、これは期待に反してチューリング完全ではありませんでした。入力層と出力層のみの2層からなるパーセプロトンはではXORなどの線形非分離な問題は絶対に学習できないことが指摘されます。いわゆる「XOR問題」。いくら形式ニューロンの組み合わせで原理的にチューリング完全でも、学習機構の制限によってできない。パーセプトロンまでは脳のニューラルネットのモデル化でしたが、XOR問題あたりでニューラルネットと線形回帰の等価性の数学的証明など研究が著しく進みます。このあたりが機械学習が統計学に還元される萌芽でしょう。
実は単純パーセプトロンでも人口ニューロンの活性化関数に一次関数ではなくて二次関数以上を採用すればXOR問題は解けるという話もあるんですが、そもそも一次関数にこだわっているのは、シナプスの可塑性の原理にあるっぽいです。自然をリスペクトしているのかどうかはわかりません。しかし単純パーセプトロンさえ。その割には学習機構にヘブ則もへったくれもない、一回数学世界に還元したような学習機構がダブルスタンダードで、当時の自分はこの辺が特に??でした。

パーセプトロンのXOR問題以降その後10年ぐらい人工知能ブームが停滞します。希望って大事ですね。その後、線形分離不可能なXOR問題を解決しチューリング完全にすべく、多層で学習を可能にしたバックプロパゲーション(誤差逆伝播学習法)機能つきの多層パーセプトロンが地道に研究しつづけていた人たちによって発明されます。もうこの頃は、人口ニューロンの活性化関数が連続で微分可能でないといけない、確率的最急降下法だとか、完全に脳のニューロモデル、ヘブ則とかぶっちぎっていました。人間の脳神経細胞が微分とかしているわけがないので、ニューラルネットをモデル化しながら統計的学習手法とかやってるダブスタな潮流を眺めながら「何かが完全におかしい」と感じた当時の自分が機械学習の学習に完全に興味を失ってしまったのでした。まあ今でもディープラーニングと言いながらディープな階層、CNN、ボルツマンマシンだとニューラルネットやっているわけで、Googleネコ概念認識の実験にしてもいまだニューラルネットです。その実装の方向性は違うと思っていますが、要するにニューラルネットのクラスタ化と各クラスタでの特徴抽出(次元削減)がキモのようで、この辺はすべてニューラルネットでなく抽象化したベイズ統計に還元、一元化できるはずです。

特にまるで別分野で発展してきた、自然言語解析方面でのデータサイエンス界隈の知見の集積がものすごくて、そこでの最先端はもちろんベイズ理論で、特にクラスタリング、生成モデルで、ノンパラメトリックベイズ法、階層ディリクレ過程が衝撃的です。(ベイズ推定の最初の「事前確率」はどうするのか?)
ディープラーニングのクラスタ化自体を教師なし学習させるのが課題だと思うのですが、もうすぐ誰かがこの辺全部統合して、そこからさらに研究、実装の進化が加速すると予想します。画像認識でも階層ディリクレ過程とマルコフ確率場を利用した教師なし画像領域分割とか、すでに、どうやるか?ではなく、もう日本人でも優秀な人が誰がすぐやるか?のフェイズのブレイクスルーが山積みだと思います。

参考書の紹介など

以上、ニューラルネットはすでに古典的モデルであり、もれなくすべてベイズ統計に還元できる、ということを強調しました。歴史的な研究として学ぶのは良いと思うのですが、既存のニューラルネットを改善して、、、という研究の方向性はかなり筋が悪いと信じます。ニューラルネットは現在非常にとっちらかっていて、今後100%統計学的なデータサイエンス特にベイズ統計に一元化されるべきですし多分そうなっていくでしょう。
その意味で、非常に良いと思ったのが、結構最近の教科書、Prince本です。

Computer vision:
models, learning and inference
Simon J.D. Prince
July 7, 2012

です。
この本ではもはやニューラルネットやバックプロパゲーションなどそういうものは一切出てきません。100%ベイズです。
しかも、なんと個人使用に限り、無料で公式サイトからダウンロードできます。
http://www.computervisionmodels.com/
紙の本で買いたい人は、Amazonで10000円くらいで買えます。和訳の本はありません。

しかし、更に素晴らしいのは、
公式サイトに、
Japanese Video Lectures by Toru Tamaki
とあるので、見てみると、
https://www.youtube.com/channel/UCirqYKKjRztDywdQXLDYYAg
https://www.youtube.com/playlist?list=PLDVKrmVEl_WtGqMo6OWBiK7P9IsTPmTjO
https://www.udemy.com/computervision/learn/
と、広島大のToru Tamaki先生によるオンライン講義があり、ほぼ実質和訳として視聴できます。通して拝見しましたが、わかりやすいし透明黒板での動画とか教育に熱意を感じます。ものすごい準備と撮影に時間、手間がかかっていることでしょう。この人は素晴らしいです。Prince本もそうですが、正直、なんでこんな良質なものがネットで読めたり、視聴できるのかよくわかりません。Udemyのほうでは、Prince本の前半部分だけで、後半は有料配信なんだろうか、と思っていましたが、上述のとおりYoutubeで後半もあります。

Princeはベイジアンですが、上述のノンパラメトリックベイズモデルについては残念ながら語っていません。
その意味で必読なのが、通称「続パタ」です。

石井健一郎,上田修功:続・わかりやすいパターン認識(教師なし学習入門),pp. 326,オーム社(2014)です。

11章ではノンパラメトリックベイズモデルの基礎となるディリクレ過程やその実現例となる Chinese RestaurantProcess や Pitman-Yor 過程などについて丁寧に解説され、12 章では,ディリクレ過程混合モデルとその学習法について解説し,クラスタ数が未知の場合のクラスタリングの具体的な方法について説明されています。ノンパラメトリックベイズモデルについて国内で詳しく解析された書籍はほとんどないので、この本の評価が高いとすれば、それが理由でしょう。
もちろんこれも、第1章 ベイズ統計学からはじまる全力のベイジアン本です。11 ~ 13 章について主に執筆を担当している上田氏は現在,NTTコミュニケーション科学基礎研究所において「機械学習・データ科学センター」センター長でおられるようです。

最後にパターン認識と機械学習 - ベイズ理論による統計的予測(Pattern Recognition and Machine Learning)=PRML通称Bishop本

これもベイズ本ですが、テクストとして網羅的であろうとして、いろんなことも書いてあります。たとえばサポートベクトルマシン(SVM)とかは一過性のものだと思いますのであんまり興味は出ません。内容もさすがにちょっと古くなってきています。ただ必読書。

ベイズ入門者向け

超最近出た本。通り一辺倒の数式説明ではなく、「考え方」「概念」の解説に情熱がある著者で、シンパシーもあり。多分一番入門者向け。しかしちゃんと最終的にベータ分布あたりまで到達している。

「完全独習」と合わせて読むと相互補完できて良いと思う。

「パターン認識と機械学習」(PRML本)と並ぶ、機械学習定番書。
しかしあくまでタイトル通り、統計的学習の基礎 ―データマイニング・推論・予測の教科書。
最初に紹介した、Computer vision:
models, learning and inference
Simon J.D. Princeがざっと流してしまっている数学要素をよりきちんと解説しているので、Prince本の理解を深めるという意味でも必読。

この日本語訳は15000円ほどと高価だが、原書は
スタンフォード大の公式サイトから、これもPDFの無料ダウンロードあり。
http://statweb.stanford.edu/~tibs/ElemStatLearn/
 

2016年2月10日水曜日

Dockerじゃないsystemd-nspawn+machinectlが非常に良い

前回、

自作FRPライブラリTimeEngineをブラッシュアップして
http://timeengine.github.io/
を公開しました。
次回は、その日本語訳、
Reactの応用技術、あるいはReact再入門についての記事をUPしますのでお楽しみに!

と書いていたのですが、Dockerじゃないsystemd-nspawn+machinectlが非常に良い、ので予定を変更して、こちらを先にエントリします。いろいろ印象を忘れないうちに。TimeEngineに関してはとりあえず自分がすでに英文で書いたものを和訳してどこかにUPしておいたほうが、何か別展開や国内のためになるかな程度のことなのでお急ぎの方は上記リンクから英文読んでください。そちらも全部仕上がっているとは言えないですし、行き届いていないところをセルフチェックするために和訳もしておこうという感じです。

実用的で枯れた技術「コンテナ」

UNIX/Linuxの世界では、OSのコンテナ技術はずいぶんと昔から存在していました。

Dockerの持つ意味とこれから起こること(NTT DATA)

実用的で枯れた技術「コンテナ」
メインフレームや商用UNIXの世界では、コンテナ型仮想化技術は古くから使われていました。Solaris Containers, HP-UX Containersなど、アプリケーションの実行環境とワークロードを安全かつ低オーバーヘッドで分離することを目的としたこれらの技術は、ミッションクリティカル領域での事例も十分あり、20世紀の時代から使われている極めて実用的で枯れた技術でした。ところが、Linuxの世界でコンテナ技術は長らく脚光を浴びることがありませんでした。コンテナ技術不遇の時代、Linuxの世界で「実行環境とワークロードを安全に分離する」のは、ソフトウエアによるハードウエアのエミュレーション、すなわち、仮想マシンを動作させる仮想化技術が主たる役割を担ってきました。クラウドサービス、特にIaaSの実用化は世の中の仮想マシンの数を爆発的に増大させました。スモールスタートが可能、需要に応じて迅速にリソース量を変化させられる、低レイヤーの運用管理はクラウド事業者におまかせ、スケールメリットによる圧倒的低コスト……流行らないわけがありません。
“ご注文は仮想マシンでよろしかったでしょうか?”
そんな中、整備が遅れていたLinuxカーネルのコンテナ技術(namespaces, cgroups)が出揃い、さらに、それをフル活用したDocker参考1がリリースされてから、多くの人が気付きはじめました。当初やりたいことは、「実行環境とワークロードを安全に分離する」ことであり、「ハードウエアをエミュレーションする」ことは、その手段として最適だったのか?もっと軽量で取り扱いしやすい方法があったのではないか?と。

私はLinux使う前はOracleに買収される前のSunMicrosystemsが全力で開発していたSolarisをデスクトップ環境でも愛用していて、その頃は、他のOSの追随を許さないZONE(Solarisコンテナ)もある、ZFSもある、ものすごい先進的なOSだ!ということでLinuxなぞ使いたくなかった時期がありました。
もちろんLinuxを試したり、またSolarisに戻ったりと試行錯誤していたのですが、SunがOracleに買収されていろいろ残念なことになったり、LinuxはLinuxでしぶとく進化を続けたりして結局Solarisには戻らなくなってしまいました。開発元のSunは、Solarisコンテナ、ZFS、VirtualBoxなど、単一の会社で素晴らしい技術を世に先んじてリリースするという、技術力が傑出していた素晴らしい会社でした。

仮想化がなぜ素晴らしいのか?

色々言われていますが、大局的観点からいうと、それはハードウェア=物質的制約からの開放である、と言えます。

根本的には、「情報処理」というのは、情報を処理するのであって、ハードウェアを処理する行為ではありません。ハードウェアというのは情報処理のために必要な手段であり、土台にすぎず、情報処理の目的ではありません。必要なハードウェアは物質なので物質的な制約が存在しています。まず、物質としての固有の厳然たる単位が存在します。つまり、このサーバ一台と別のサーバを繋げて、それぞれメモリがいくらでドライブが、、、などなど諸々の制約があり、それぞれの単位にはそれぞれ物質としての経済的コストもかかります。

この情報処理として本質なマネージメントではないハードウェアのレイヤーの上位のレイヤーで抽象化して、一切合切の物質的わずらわしさから開放されたい、開放しよう、というのが「仮想化」であるということになります。

Sunの技術者が開発した先進的なファイルシステムであるZFSもHDDやらのファイルストレージというハードウェアの仮想化です。Windowsでは、今でもなおファイルシステムの構造が今でも、Cドライブが根本とかそういうことになっているわけですが、そもそもUNIXでは、ドライブという物質的概念は抽象化されて常にルートディレクトリが根本です。物理的なドライブは各ディレクトリに「仮想化」されてマウントできる、という設計思想になっています。しかしこの場合であっても、なおあらかじめボリュームから切り出すパーティションのサイズを決め打ちして各ディレクトリに配分する、というのは、どの程度配分すれば十分なのか?また無駄にならないのか?と決め打ちするだけのある種の知見や職人技が必要とされ、ある種の思い切りというか勇気が必要な作業でもあります。これをストレージプールというハードウェアの論理的集合体としてまとめて、臨機応変にファイルシステムに配分できるようにしたのがZFSです。

結局のところ、ZFSにせよVMWare,VirtualBoxにせよコンテナにせよ、ハードウェアを先に全部まとめて後から論理的にリソースを配分するという仮想化技術は、まったく同じ設計思想に基づいています。

古くて新しいコンテナ仮想化~Dockerで新たなアプリケーション配布スタイルへ~

(NTT DATA)

enter image description here

という認識が、Dokcerの普及によって広く一般的になりつつある、気もするのですが、旧来からあったUNIXのコンテナ技術であるSolarisゾーンはVMwareなどのようにハードウェアをエミュレートするものではないものの、1つのSolarisカーネル上で複数のSolarisを動作させる複数の仮想 Solaris環境です。

Dockerは1コンテナ=1アプリ=1プロセスのような設計思想ですが、旧来のSolaris的コンテナ技術からいえば、結構極端である、と言えます。

SolarisやLinuxのように同じカーネルを共用出来る場合は、ハードウェア仮想化というのは必要ではなく、コンテナ仮想化のほうが効率的なのでコンテナのほうを使いたいわけですが、SolarisゾーンみたいなのがUNIX系のコンテナだと思っていた自分にとっては、1コンテナ=1アプリ=1プロセスだ、というDockerの設計思想による制約は個人的には馴染みません。

もちろん、Dockerには1アプリがコンテナの粒度に統一してそれを配布する、というパッケージングによるマーケティング、人気の理由があるわけですが、人気があって普及しているからといって技術的に優れているわけではなく、それは単にそのような設計思想がトレンドに馴染んだということにすぎません。
Dockerはコンテナはアプリであり、データはデータ・ボリュームに分離すべきであり、そのオプションと利用法がどうとか、Dockerコンテナ内でsshdを実行してはいけない理由があって、HOWTOがあったりと、手軽さのための設計思想が、柔軟性、自由度をあまりにも制約しすぎていて使いづらい技術だな、というのが私の印象です。

MicroSoft Azure クラウドマシン上でのコンテナ

ということで、触ってはみたが、まったくハマれなかったDockerですが、最近Azureのクラウドマシンで、Arch-Linuxのサーバを建てたいと思って調べてみましたが、ローリングアップデートリリースなArchはサーバ界でいまいち人気ないようでイメージが存在しませんでした。そこで、CoreOS+DockerコンテナでArchインストールすればいいやとおもって、とりあえずやってみたのですが、やはりコレジャナイ感が半端なく、別の方策、より従来のコンテナ技術らしい派閥のUbuntu+LXD( LXC)コンテナをトライしようとしましたが、やはりArchはまったく人気がないようでイメージが存在しませんでした。もちろん多分自分でイメージを構築するとかやり方は存在するんでしょうが、わからないし、結構大変な気がして何のために作業をやっているのかわからない危険性を感じました。そうやって調べているうちに発見したのが、systemd-nspawn+machinectlという選択肢でした。

Dockerじゃないsystemd-nspawn+machinectlが非常に良い

Dockerより柔軟なコンテナ型仮想化 systemd-nspawn を使ってみた

Docker の愚痴
Dockerはコンテナ内でのsystemdに問題があり、systemctlでサービスの起動ができません。
というより本来そんな操作で動かすものじゃない・・・。
なんとか動かす手順もあるんですが、まぁ〜〜〜これが面倒くSay YO ☆
そもそもDockerは1コンテナ=1プロセスにすべきみたいな思想を掲げているんですが、この辺が私に合わない。
進歩の激しいOSS界で1コンテナ=1プロセスなんて無謀というか意味あんのっていうか。
規模の大きいサービスを1つだけ動かすみたいな場合はそれの方がいいでしょうけど、個人、もしくは少人数でそんな細切れコンテナ管理したくはないかな。
Dockerが合わない、わからないって人は大抵この話題ですよね。
どうせチューニングは必要になるんだし、それならコンテナに一時的に入ってイジったほうが手っ取り早くない?
んで色々イジってたら面倒臭くなるんだって。
まぁメールとかDBとかスタンダードなものは分けたい気持ちはわからんでもないですよ。

systemd-nspawnを活用してVPSの構成を根底から見直した

systemd-nspawnで使うmachinectlが素晴らしい事になってた

systemd-nspawn+machinectlで検索しても日本語は皆無に近い状況のなかの記事です。

非常に良いのに、あんまりにも周知されていない人気のなさを憂いた、というのがこのエントリの動機でもあります。

Dockerは過大評価、systemd-nspawnは過小評価されている。まあ確かに前者はブレイクして、後者は新規ではあるんですが、新規であっても目ざとく発見して客観的評価が得意そうな技術世界も世間の流れに追随するだけの人の子、というのは常々感じる不条理ではあります。

ちなみに、比較的認知されているCoreOSの開発者がDockerじゃないフルのコンテナ技術として開発したのが、systemd-nspawnベースのRocket ですがイマイチ人気出ません。あんまり良くないようでベースのsystemd-nspawnそのままが進化しているのでより不要感が半端ない状況のようです。

あぁ、そうそう最近rocket(rkt)の最新版を試しましたが、ぶっちゃけsystemd-nspawnが肌に合う人には向きません。
manifestファイル?これ利点ある?ないよね。
今から利点作るの?
まさかまたsupervisor使わせるの・・・?
なんてダサいんだろう。
enterさせるくせに一々これに稼働させるプロセス書かないといかんのかい?
しかもaciも偉そうに規格化だの言ってるけど、ただmanifestファイルとrootfsをtarで固めてるだけ。
当然runするのにも展開しなきゃいけないもんだから初動が糞遅い。
便利さはDocker未満で柔軟さはsystemd-nspawn未満ですかね。
全然期待していたものとは違いました。
systemd-nspawn好きでrktが安定したら移行しようとか思ってた人は早々に諦めた方が良いです。

npmライブラリの開発でもなんでもそうですが、依存する技術は、ソリッドでミニマルで基本的なものに限定したほうが、コントロール不能な外部要因としてのバグに翻弄されることもないし、rktじゃなくて、ベースのsystemd-nspawnで良いと思います。

systemd-nspawn+machinectlが非常に良いところ


  • 設計思想
    1コンテナ=1アプリ=1プロセスのような設計思想の縛りが存在せず、柔軟で自由。
    従来、本来のコンテナとしての設計。

  • スタンダード
    Linuxディストロの主流となったsystemdの一部として存在している、LinuxOSプロセス管理そのものの派生機能である。systemdベースのUbuntu,Debian,Arch,CentOSなどで使える。標準化的に問題なし。systemdの開発者であるLennart Poetteringが開発している。いわば謹製で純粋。

  • バグ、安定性、信頼性
    設計思想もそうだが、そもそもLinuxOSプロセス管理そのものの派生機能なので、バグの存在、安定性もろもろDockerその他よりもかなり信頼できる。

  • 新規性
    systemd自体がLinux世界で普及したのは比較的最近のことであり、さらに、systemd-nspawnというコンテナ技術が登場したのもかなり最近。現在活発に開発が進んでおり進化が早い。

    systemd-nspawnで使うmachinectlが素晴らしい事になってた
    なんとpull-tar,pull-raw,pull-dkrがあるじゃあないですか。
    これらは/usr/lib/machinesにダウンロードしてsystemd-nspawnで使える状態にするみたいですね。
    pull-dkrはその名の通り、docker hubなどからdockerイメージを引っ張ってこれちゃう。
    machinectl pull-dkr –verify=no base/archlinux –dkr-index-url=https://index.docker.io
    こんな感じで。
    ちょっとこれ凄くない?

という新規性もあるのですが、最初は確かにすごいな、と感じたのですが、いじっているうちに、不要かな、と思いました。個人的にこのDockerで一段と普及した、コンテナのイメージ⇔コンテナのワークフローが非常に煩雑で馴染みません。

  • ミニマルでシンプル、だからパワフル
    というのが設計でもっとも重要だと常に感じます。systemd-nspawnはそれなので、イメージなんちゃらとかあんまりいらんなあ、という感じ。

  • 統合性、透明性
    というのは、誤解されやすいワーディングではあるのですが、とにかく強くそう感じます。
    systemd-nspawnは、systemdeの一部として、同じ設計思想で同じ技術者によって開発されている技術なので、systemdと完全に統合されています。たとえば、上記引用記事の「Docker の愚痴」にもあるとおり、Dockerではコンテナ環境としてここに問題アリなのですが、systemd-nspawnではコンテナのなかでsystemdサービスはsystemctlで普通にenable,startして隔離してコントロールできます。「プロセスツリーや様々な IPC サブシステム、ホスト・ドメイン名も完全に仮想化」されます。カーネル共用しているコンテナなのでsystemdもホストと共用するしかない、というのはまったく事実でなく、非常に美しいです。

https://wiki.archlinuxjp.org/index.php/Systemd-nspawn

systemd-nspawn は chroot コマンドに似ていますが、chroot を強化したものです。
systemd-nspawn を使えば軽量な名前空間コンテナでコマンドや OS を実行することができます。ファイルシステム構造だけでなく、プロセスツリーや様々な IPC サブシステム、ホスト・ドメイン名も完全に仮想化するため chroot よりも強力です。
systemd-nspawn は /sys, /proc/sys, /sys/fs/selinux などのコンテナの様々なカーネルインターフェイスへのアクセスを読み取り専用に制限します。コンテナの中からネットワークインターフェイスやシステムクロックを変更することは出来ません。デバイスノードを作成することも不可能です。コンテナの中からホスト環境を再起動することはできず、カーネルモジュールをロードすることも制限されます。
仕組みとしては Lxc-systemd や Libvirt-lxc と異なり、とてもシンプルなツールで設定を行います。

「chroot を強化したもの」という様式でファイルシステム構造を隔離するというのは、既存のホストOSの一部として安全に隔離されており、なお普通にホストでディレクトリ降りたらchrootで管理しているファイルシステムなので、透明に管理できます。つまり、Dockerコンテナ内のファイルを操作するには!?データボリュームが・・・というツール固有のオペレーションは一切不要で、透明にアクセスできます。逆に、隔離されたコンテナ内からホストのファイルを操作したい、という場合に、はじめてchrootの強化機能としてのsystemd-nspawnの役割が出てきます。

ネットワーク管理も、VMWareなどのハードウェアParavirtualizationに類似していて、ホストのイーサネット、ブリッジアダプターがゲストで仮想化されて渡されます。

systemd-nspawn -hすると該当部分はこんな感じ。

     --private-network      Disable network in container
     --network-interface=INTERFACE
                            Assign an existing network interface to the
                            container
     --network-macvlan=INTERFACE
                            Create a macvlan network interface based on an
                            existing network interface to the container
     --network-ipvlan=INTERFACE
                            Create a ipvlan network interface based on an
                            existing network interface to the container
  -n --network-veth         Add a virtual ethernet connection between host
                            and container
     --network-bridge=INTERFACE
                            Add a virtual ethernet connection between host
                            and container and add it to an existing bridge on
                            the host
  -p --port=[PROTOCOL:]HOSTPORT[:CONTAINERPORT]
                            Expose a container IP port on the host

もちろん、コンテナOS内の隔離された環境でSSHサーバ建てるなり自由にやれば良いわけで、一切の制約はありません。


以上、適当に列挙してみましたが、非常に良いです。
はじめてVMWareでOSの仮想化を体験した感慨が、Linuxのコンテナ仮想化でふたたび得られたという感じ。

仮想化がなぜ素晴らしいのか?というところでまとめましたが、Linuxのオペレーションにおいて、ハードウェアの抽象化は恩恵があるのですがVMWareなどのハードウェアParavirtualization、EC2、Azure
などのクラウドマシンによる仮想化は、まだパフォーマンスのオーバーヘッド、そしてクラウド上ではコストがかかります。しかし、systemd-nspawnコンテナを使えば、同等の体感が、コンテナというパフォーマンスのオーバーヘッドが極小の技術で可能になったのはメリットが甚大です。

systemd-nspawnでUbuntuServerホストのコンテナでArch仮想マシンを起動してみよう

結局、今回やりたかったことはこれです。
Azureのクラウドマシンで、Arch-Linuxのサーバを建てたいと思ったが、イメージも存在せずサポートもされていなかったので、UbuntuServer15.10のコンテナ内で、Archを起動したい。
UbuntuServerは、systemdベースでよくメンテナンスされており、カーネルバージョンが新しかったので選択。

systemd-nspawn は chroot コマンドに似ていますが、chroot を強化したものです。

と言う感じで、従来の既存技術の延長で、透明に管理できてしまいます。これが大きい。
つまりDockerのように固有のフォーマットのイメージをpullするには?また作成するには?とか新規に技術を習得すべき固有の仕様は全くないです。

ArchLinuxを使っているギークはArch-Linuxをインストールする場合、皆chrootでベースシステムの設定していくわけで、そのままやれば良い。

Archのダウンロードサイトには、ブートストラップファイルがあるので、ファイルをダウンロードして、適当なディレクトリで解凍して、ルートファイルシステムそのものをコンテナイメージとします。

# ken at kenubuntu07 in /zfspool/arch1 [7:59:18]
$ l
total 55K
drwxr-xr-x 16 root root   21 Feb 10 00:09 .
drwxr-xr-x  3 root root    5 Feb 10 07:42 ..
lrwxrwxrwx  1 root root    7 Sep 30 19:17 bin -> usr/bin
drwxr-xr-x  2 root root    5 Feb 10 00:09 boot
drwxr-xr-x  2 root root    2 Feb  1 15:43 dev
drwxr-xr-x 38 root root   95 Feb 10 00:35 etc
drwxr-xr-x  3 root root    3 Feb 10 00:02 home
lrwxrwxrwx  1 root root    7 Sep 30 19:17 lib -> usr/lib
lrwxrwxrwx  1 root root    7 Sep 30 19:17 lib64 -> usr/lib
drwxr-xr-x  2 root root    2 Sep 30 19:17 mnt
drwxr-xr-x  2 root root    2 Sep 30 19:17 opt
dr-xr-xr-x  2 root root    2 Feb  1 15:43 proc
-rw-r--r--  1 root root 1.3K Feb  1 15:43 README
drwxr-x---  3 root root    4 Feb 10 00:06 root
drwxr-xr-x  2 root root    2 Feb  1 15:43 run
lrwxrwxrwx  1 root root    7 Sep 30 19:17 sbin -> usr/bin
drwxr-xr-x  4 root root    4 Feb  9 23:57 srv
dr-xr-xr-x  2 root root    2 Feb  1 15:43 sys
drwxrwxrwt  2 root root    2 Feb  1 15:43 tmp
drwxr-xr-x  8 root root   10 Feb 10 00:09 usr
drwxr-xr-x 12 root root   16 Feb 10 00:09 var

ディレクトリが、/zfspool/arch1となっているのは、
AzureのUbuntuサーバにデータ用ディスクとして128GのSSDドライブを別途用意して、
UbuntuにZFS-Linuxをインストールし、/dev/sdc全体をZFSのプールにしてマウントした

$ sudo zpool create zfspool /dev/sdc

からです。

次に、Ubuntu15.10サーバにはあらかじめlxcbr0というブリッジアダプタが存在していたので、それをコンテナのネットワークブリッジアダプタとして利用するオプションを加えながら、上記ディレクトリを指定して「仮想マシン」をブートします。

$ sudo systemd-nspawn --directory=/zfspool/arch1 --network-bridge=lxcbr0 --boot
Spawning container arch1 on /zfspool/arch1.
Press ^] three times within 1s to kill container.
Failed to create directory /zfspool/arch1/sys/fs/selinux: Read-only file system
/etc/localtime is not a symlink, not updating container timezone.
systemd 228 running in system mode. (+PAM -AUDIT -SELINUX -IMA -APPARMOR +SMACK -SYSVINIT +UTMP +LIBCRYPTSETUP +GCRYPT +GNUTLS +ACL +XZ +LZ4 +SECCOMP +BLKID +ELFUTILS +KMOD +IDN)
Detected virtualization systemd-nspawn.
Detected architecture x86-64.

Welcome to Arch Linux!

Failed to install release agent, ignoring: File exists
display-manager.service: Cannot add dependency job, ignoring: Unit display-manager.service failed to load: No such file or directory.
[  OK  ] Listening on Network Service Netlink Socket.
[  OK  ] Reached target Remote File Systems.
[  OK  ] Started Dispatch Password Requests to Console Directory Watch.
[  OK  ] Listening on LVM2 metadata daemon socket.
[  OK  ] Created slice User and Session Slice.
[  OK  ] Started Forward Password Requests to Wall Directory Watch.
[  OK  ] Listening on Device-mapper event daemon FIFOs.
[  OK  ] Listening on Journal Socket (/dev/log).
[  OK  ] Listening on Journal Socket.
[  OK  ] Created slice System Slice.
[  OK  ] Created slice system-getty.slice.
         Mounting FUSE Control File System...
         Mounting Huge Pages File System...
[  OK  ] Reached target Swap.
         Starting Journal Service...
         Mounting POSIX Message Queue File System...
[  OK  ] Listening on /dev/initctl Compatibility Named Pipe.
         Starting Remount Root and Kernel File Systems...
[  OK  ] Reached target Encrypted Volumes.
[  OK  ] Reached target Paths.
[  OK  ] Reached target Slices.
[  OK  ] Mounted FUSE Control File System.
[  OK  ] Mounted Huge Pages File System.
[  OK  ] Mounted POSIX Message Queue File System.
[  OK  ] Started Remount Root and Kernel File Systems.
[  OK  ] Reached target Local File Systems (Pre).
[  OK  ] Reached target Local File Systems.
         Starting Load/Save Random Seed...
[  OK  ] Started Load/Save Random Seed.
[  OK  ] Started Journal Service.
         Starting Flush Journal to Persistent Storage...
[  OK  ] Started Flush Journal to Persistent Storage.
         Starting Create Volatile Files and Directories...
[FAILED] Failed to start Create Volatile Files and Directories.
See 'systemctl status systemd-tmpfiles-setup.service' for details.
         Starting Update UTMP about System Boot/Shutdown...
[  OK  ] Started Update UTMP about System Boot/Shutdown.
[  OK  ] Reached target System Initialization.
[  OK  ] Started Daily verification of password and group files.
[  OK  ] Started Daily rotation of log files.
[  OK  ] Listening on D-Bus System Message Bus Socket.
[  OK  ] Reached target Sockets.
[  OK  ] Started Daily Cleanup of Temporary Directories.
[  OK  ] Started Daily man-db cache update.
[  OK  ] Reached target Timers.
[  OK  ] Reached target Basic System.
         Starting Login Service...
[  OK  ] Started D-Bus System Message Bus.
         Starting Network Service...
         Starting Permit User Sessions...
[  OK  ] Started Login Service.
[  OK  ] Started Permit User Sessions.
[  OK  ] Started Console Getty.
[  OK  ] Reached target Login Prompts.
[  OK  ] Started Network Service.
[  OK  ] Reached target Network.
         Starting Network Name Resolution...
[  OK  ] Started Network Name Resolution.
[  OK  ] Reached target Multi-User System.
[  OK  ] Reached target Graphical Interface.

Arch Linux 4.2.0-27-generic (console)

arch1 login: 

美しいですね。
コンテナであっても、まるでVMWareの仮想マシンのブートを見ているようです。しかもコンテナなので、ブートは一瞬です。(今回Azureで作成したクラウドマシンのスペックで1秒以内)

Systemdと完全に統合されているので、隔離された仮想マシンで隔離されたSystemdのサービスが起動されています。

[FAILED] Failed to start Create Volatile Files and Directories.

という、Systemdの最近のバージョンのバグによるファイルシステムとの相性問題まで忠実に再現されているというオマケつき。
あとは、このArchブートストラップのファイルシステムの延長線上にPacmanでArchのフルシステムを構築していけばよいです。通常のArchインストールのように、インストールスクリプトなどを利用して、ここから外のターゲットディレクトリに向けて構築するのは不要なので、このchrootディレクトリのまま適当にベースシステムインストールして育てていきます。

通常のArchインストールのように、ネットワーク設定では普通に

# systemctl enable systemd-networkd  systemd-resolved

このように、SystemdUnitをsystemctl enableしていきます。

machinectlによるコンテナマシン管理

systemd-nspawnに付随するユーティリティmachinectlが存在しています。

$ machinectl -h
machinectl [OPTIONS...] {COMMAND} ...

Send control commands to or query the virtual machine and container
registration manager.

  -h --help                   Show this help
     --version                Show package version
     --no-pager               Do not pipe output into a pager
     --no-legend              Do not show the headers and footers
     --no-ask-password        Do not ask for system passwords
  -H --host=[USER@]HOST       Operate on remote host
  -M --machine=CONTAINER      Operate on local container
  -p --property=NAME          Show only properties by this name
  -q --quiet                  Suppress output
  -a --all                    Show all properties, including empty ones
  -l --full                   Do not ellipsize output
     --kill-who=WHO           Who to send signal to
  -s --signal=SIGNAL          Which signal to send
     --uid=USER               Specify user ID to invoke shell as
     --setenv=VAR=VALUE       Add an environment variable for shell
     --read-only              Create read-only bind mount
     --mkdir                  Create directory before bind mounting, if missing
  -n --lines=INTEGER          Number of journal entries to show
  -o --output=STRING          Change journal output mode (short,
                              short-monotonic, verbose, export, json,
                              json-pretty, json-sse, cat)
      --verify=MODE           Verification mode for downloaded images (no,
                              checksum, signature)
      --force                 Download image even if already exists
      --dkr-index-url=URL     Specify the index URL to use for DKR image
                              downloads

Machine Commands:
  list                        List running VMs and containers
  status NAME...              Show VM/container details
  show [NAME...]              Show properties of one or more VMs/containers
  start NAME...               Start container as a service
  login [NAME]                Get a login prompt in a container or on the
                              local host
  shell [[USER@]NAME [COMMAND...]]
                              Invoke a shell (or other command) in a container
                              or on the local host
  enable NAME...              Enable automatic container start at boot
  disable NAME...             Disable automatic container start at boot
  poweroff NAME...            Power off one or more containers
  reboot NAME...              Reboot one or more containers
  terminate NAME...           Terminate one or more VMs/containers
  kill NAME...                Send signal to processes of a VM/container
  copy-to NAME PATH [PATH]    Copy files from the host to a container
  copy-from NAME PATH [PATH]  Copy files from a container to the host
  bind NAME PATH [PATH]       Bind mount a path from the host into a container

Image Commands:
  list-images                 Show available container and VM images
  image-status [NAME...]      Show image details
  show-image [NAME...]        Show properties of image
  clone NAME NAME             Clone an image
  rename NAME NAME            Rename an image
  read-only NAME [BOOL]       Mark or unmark image read-only
  remove NAME...              Remove an image
  set-limit [NAME] BYTES      Set image or pool size limit (disk quota)

Image Transfer Commands:
  pull-tar URL [NAME]         Download a TAR container image
  pull-raw URL [NAME]         Download a RAW container or VM image
  pull-dkr REMOTE [NAME]      Download a DKR container image
  import-tar FILE [NAME]      Import a local TAR container image
  import-raw FILE [NAME]      Import a local RAW container or VM image
  export-tar NAME [FILE]      Export a TAR container image locally
  export-raw NAME [FILE]      Export a RAW container or VM image locally
  list-transfers              Show list of downloads in progress
  cancel-transfer             Cancel a download

このコマンドで、コンテナマシンを
poweroffしたり、 rebootしたりできます。
まさにVMWareの仮想マシンそのもの。美しいですね。.

ホストから

$ machinectl status arch1

と叩いてやると、コンテナマシンのIPやらSystemdのUnitツリーやら諸々の情報が確認できます。

arch1
           Since: Wed 2016-02-10 07:42:52 UTC; 33min ago
          Leader: 27171 (systemd)
         Service: nspawn; class container
            Root: /zfspool/arch1
           Iface: lxcbr0
         Address: 10.0.3.149
                  169.254.173.34
                  fe80::3433:76ff:fed0:b73a%3
              OS: Arch Linux
            Unit: machine-arch1.scope
                  ├─init.scope
                  │ └─27171 /usr/lib/systemd/systemd
                  └─system.slice
                    ├─dbus.service
                    │ └─27219 /usr/bin/dbus-daemon --system --address=systemd: --nofork --nopidfile --systemd-activation
                    ├─systemd-journald.service
                    │ └─27203 /usr/lib/systemd/systemd-journald
                    ├─systemd-resolved.service
                    │ └─27224 /usr/lib/systemd/systemd-resolved
                    ├─systemd-logind.service
                    │ └─27218 /usr/lib/systemd/systemd-logind
                    ├─systemd-networkd.service
                    │ └─27220 /usr/lib/systemd/systemd-networkd
                    └─console-getty.service
                      └─27223 /sbin/agetty --noclear --keep-baud console 115200 38400 9600 vt220

Feb 10 07:42:52 kenubuntu07 systemd[1]: Started Container arch1.

コンテナマシンをシャットダウン(パワーオフ)してみます。
ホストで以下のように叩きます。

$ machinectl poweroff arch1
[  OK  ] Stopped target Graphical Interface.
[  OK  ] Removed slice system-getty.slice.
[  OK  ] Stopped target Timers.
[  OK  ] Stopped Daily Cleanup of Temporary Directories.
[  OK  ] Stopped Session 28 of user ken.
         Starting Generate shutdown-ramfs...
[  OK  ] Stopped target Multi-User System.
         Stopping Network Name Resolution...
[  OK  ] Stopped target Login Prompts.
         Stopping Console Getty...
[  OK  ] Stopped Daily rotation of log files.
[  OK  ] Stopped Daily verification of password and group files.
[  OK  ] Stopped Daily man-db cache update.
         Stopping User Manager for UID 1000...
[  OK  ] Stopped Console Getty.
[  OK  ] Stopped Network Name Resolution.
[  OK  ] Stopped User Manager for UID 1000.
[  OK  ] Removed slice User Slice of ken.
         Stopping Login Service...
[  OK  ] Stopped target Network.
         Stopping Network Service...
         Stopping Permit User Sessions...
[  OK  ] Stopped Login Service.
[  OK  ] Stopped Permit User Sessions.
[  OK  ] Stopped target Remote File Systems.
[  OK  ] Stopped Network Service.
         Stopping D-Bus System Message Bus...
[  OK  ] Stopped D-Bus System Message Bus.
[  OK  ] Stopped target Basic System.
[  OK  ] Stopped target Slices.
[  OK  ] Removed slice User and Session Slice.
[  OK  ] Stopped target Paths.
[  OK  ] Stopped Dispatch Password Requests to Console Directory Watch.
[  OK  ] Stopped Forward Password Requests to Wall Directory Watch.
[  OK  ] Stopped target Sockets.
[  OK  ] Closed D-Bus System Message Bus Socket.
[  OK  ] Stopped target System Initialization.
         Stopping Load/Save Random Seed...
         Stopping Update UTMP about System Boot/Shutdown...
[  OK  ] Stopped target Encrypted Volumes.
[  OK  ] Stopped target Swap.
[  OK  ] Stopped target Local File Systems.
         Unmounting /proc/sys/kernel/random/boot_id...
         Unmounting /run/systemd/nspawn/incoming...
         Unmounting /run/user/1000...
         Unmounting Temporary Directory...
[  OK  ] Stopped Load/Save Random Seed.
[  OK  ] Stopped Update UTMP about System Boot/Shutdown.
[  OK  ] Unmounted /proc/sys/kernel/random/boot_id.
[  OK  ] Unmounted /run/systemd/nspawn/incoming.
[  OK  ] Unmounted Temporary Directory.
[  OK  ] Unmounted /run/user/1000.
[  OK  ] Reached target Unmount All Filesystems.
[  OK  ] Stopped target Local File Systems (Pre).
[  OK  ] Stopped Remount Root and Kernel File Systems.
[  OK  ] Started Generate shutdown-ramfs.
[  OK  ] Reached target Shutdown.
Sending SIGTERM to remaining processes...
Sending SIGKILL to remaining processes...
Powering off.
Container arch1 has been shut down.

美しいですね。もちろんシャットダウンも一瞬です。

セキュリティ

https://coreos.com/blog/qa-with-lennart-systemd/

September 16, 2015のインタビューで、systemd projectの開発者Lennart Poetteringによれば、すでにproduction readyだそうです。実務に耐えます。

systemd also contains the systemd-nspawn container manager. It’s a relatively minimal, yet powerful implementation of a container manager. Initially we wrote it for testing purposes, but nowadays we consider it ready for many production uses. In fact CoreOS’ rkt container tool makes use of it as the lower level container backend.

クラウドマシン、VPSやVPNの構成の再考

dockerでvpnサーバーをたてる技を駆使していたり、クラウドベースでVPNやってる場合でも、systemd-nspawnで構成を全部見直したくなる人もいるでしょう。

個人的には、Azureのクラウドマシンでコストを睨みながら無闇矢鱈にサーバインスタンス増やしていろいろやるよりも、1台のクラウドマシンを建てて、そのなかのコンテナマシンで構成したほうがよりハードウェアからの開放という至上命題としての仮想化として、リソースとコストに無駄がない優れた解法だなと感じています。